
警报
Performance Analytics 会生成警报,以帮助管理员主动监控环境。当影响用户体验的因素恶化时,会生成警报。
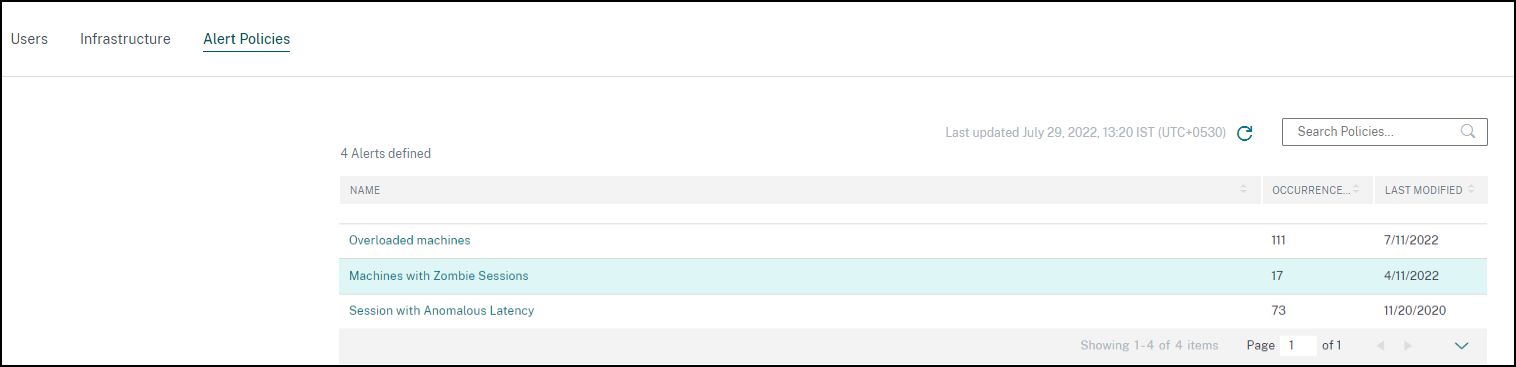
可用策略列在警报策略选项卡中。警报默认启用,可以使用状态切换按钮禁用。可以为没有 Citrix Cloud 帐户管理员访问权限的收件人启用利益相关者的警报电子邮件通知。单击警报名称以编辑邮件收件人列表。有关更多信息,请参阅电子邮件分发列表文章。
您必须在 Citrix Cloud 的帐户设置菜单中为所有收件人启用接收电子邮件通知,才能收到警报邮件。有关更多信息,请参阅通知文章。
警报通知的 Webhook 支持
您可以将 Performance Analytics 中的警报通知发布到首选的 Webhook 侦听器,例如 Slack、JIRA。这有助于企业客户自动化从事件检测到关闭的流程,从而轻松地根据 Performance Analytics 警报通知驱动工作流。
有关创建 Webhook 配置文件的信息,请参阅创建 Webhook 配置文件。
要配置基于 Webhook 的警报通知:
-
转到警报策略选项卡。
-
单击要使用 Webhook 配置的策略。
-
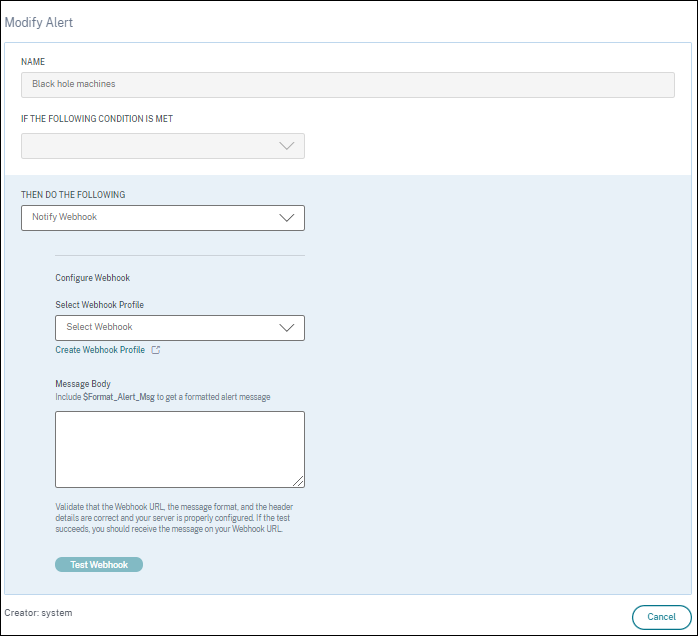
修改警报页面打开。在然后执行以下操作下拉列表中,根据需要选择通知 Webhook 或电子邮件或通知 Webhook。
-
如果已创建 Webhook 配置文件,请从选择 Webhook 配置文件下拉列表中选择正确的 Webhook。
-
在消息正文文本框中,包含
$Format_Alert_Msg字符串以获取包含存储在后端中的模板化字符串的常规警报消息。例如,要将警报消息发送到 Slack,可以使用此格式:{"text":"$Format_Alert_Msg" }。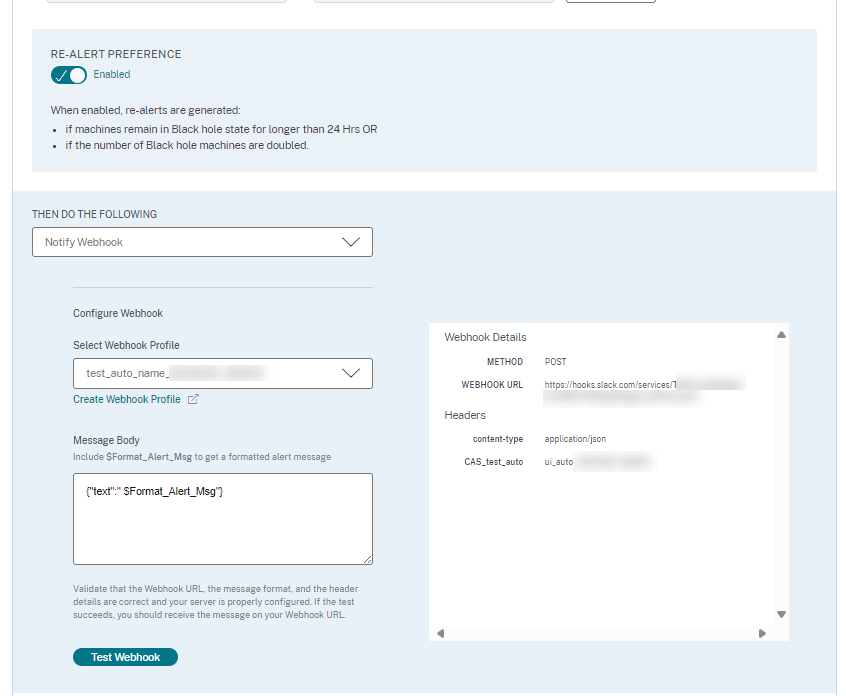
警报邮件中的 CSV 附件
黑洞机器、过载机器和僵尸会话警报电子邮件包含 CSV 附件,其中包含有关受影响机器和会话的信息。 附件包含以下数据:
-
机器名称
-
站点 ID
-
目录名称
-
交付组名称
-
故障计数(适用时为失败的机器或会话数)。
警报邮件中的 CSV 附件有助于识别故障机器和会话,而无需登录 Citrix Analytics for Performance。这有助于建立自动化管道,以创建工单并将其转发给负责快速解决问题的利益相关者。
将交付组排除在接收警报之外
您现在可以指定要排除在接收警报通知之外的交付组。您可以从警报流程中删除未使用的交付组或为测试目的创建的交付组。排除交付组有助于减少警报疲劳并提高警报的相关性。
自定义警报参数
警报策略预设了默认参数值。您可以修改警报参数,使其更符合您的环境。
单击警报策略名称以打开“修改警报”窗口。修改列出的参数值以适应您的环境。后续警报通知将根据自定义条件生成。
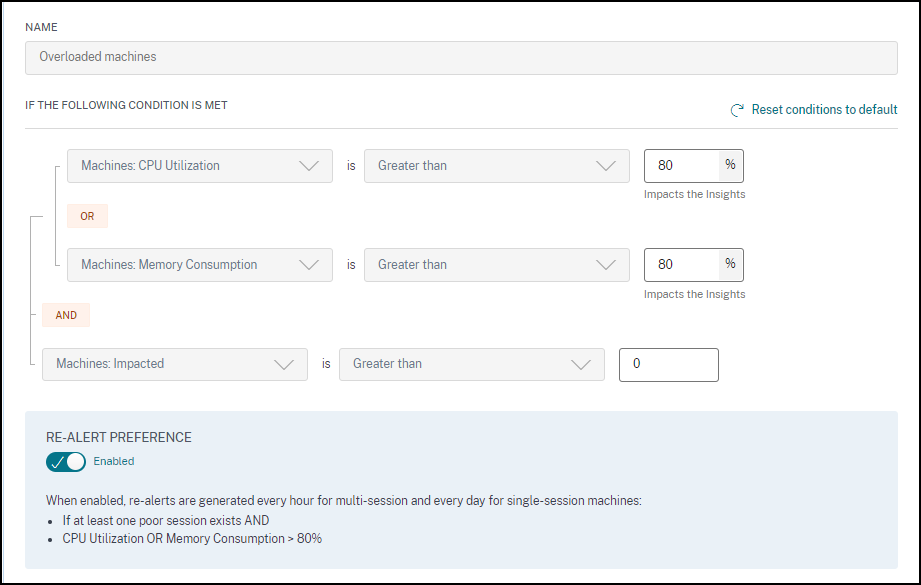
注意: 更新警报参数也会更改 UX 仪表板上相应洞察的计算结果。
在支持重新警报的警报中,您还可以控制重新警报首选项。如果重新警报首选项设置为启用,并且重新警报首选项中指定的条件持续存在,则会重新发送警报通知。
自定义警报与您的环境更相关,它们有助于轻松识别异常,并且对于主动监控更可靠。
僵尸会话计算机警报
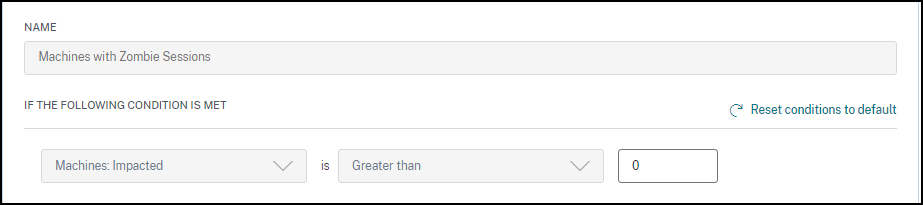
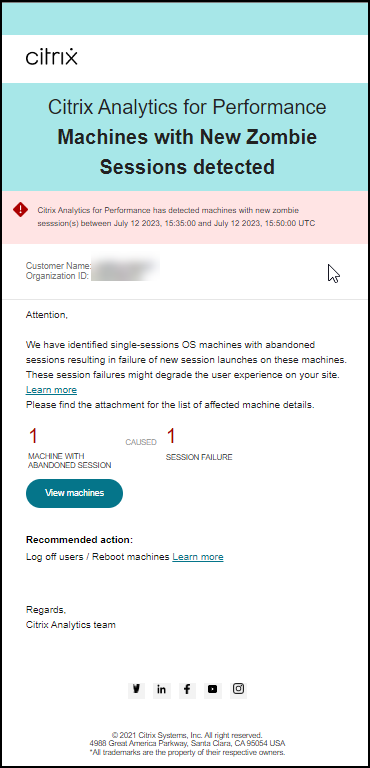
当在 15 分钟间隔内环境中检测到具有僵尸会话的新计算机时,会生成僵尸会话计算机警报邮件。
您可以自定义僵尸会话计算机警报的警报条件。
一封电子邮件警报会发送给管理员,其中包含具有僵尸会话的计算机数量以及由于僵尸会话导致的会话失败的详细信息。邮件中的数字是最近 15 分钟间隔的数据。
在邮件中单击查看计算机,可在僵尸会话计算机的自助服务视图中查看具有已放弃会话的单会话计算机。该视图反映了邮件中 15 分钟的间隔,请使用时间导航器选择更大的时间窗口。
只有当同一已放弃会话在同一台计算机上从首次检测起持续超过 24 小时时,才会对同一台计算机进行重新警报。此警报的重新警报首选项不能设置为禁用。
异常延迟会话警报
异常延迟是导致会话体验不佳的主要原因。当会话延迟值出现显著偏差时,异常延迟警报会帮助管理员。主动警报有助于管理员识别会话响应能力差的特定用户。
您可以自定义异常延迟会话警报的警报条件。
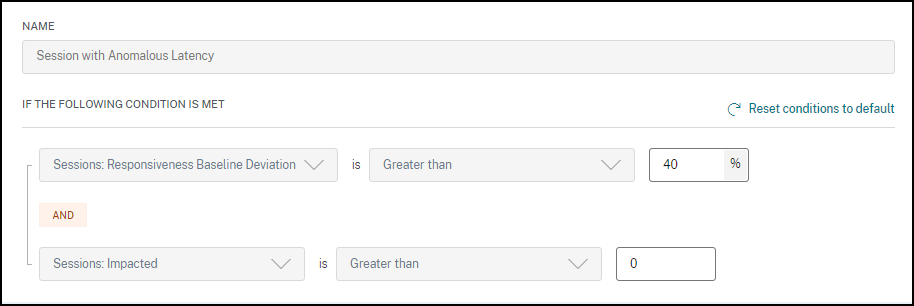
更新参数会改变异常响应会话的基线洞察计算。
此警报显示会话延迟读数偏离用户 30 天基线值的会话和用户数量。用户特定的基线是使用过去 30 天测量的 P95 ICARTT 值计算的。
异常延迟警报(/en-us/citrix-analytics/media/pa-anamolous-alert.png)
警报邮件显示了在所述时间段内面临异常响应的会话和用户数量。单击 查看会话 以查看会话自助服务页面中列出的具有异常响应的会话。
检测到的模式 部分显示了根据以下标准在具有异常响应的会话中发现的前三种模式:
-
每个交付组中具有异常响应的会话数量
-
每个端点城市中具有异常响应的用户数量
-
每个 ISP 中具有异常响应的会话数量
在分析中查看最新洞察 链接会引导至用户体验仪表板,其中显示了 洞察 面板中的最新统计数据。分析特定会话的位置、ICARTT、ISP、带宽和延迟指标,以找出问题的根本原因。有关基于会话的自助服务视图中可用指标的更多信息,请参阅 会话自助服务搜索。
过载计算机警报
持续出现 CPU 峰值、高内存使用率或两者兼有,且持续 5 分钟或更长时间,导致在选定时间间隔内用户体验不佳的计算机被视为过载。
您可以自定义过载计算机警报的警报条件和重新警报首选项。
过载计算机警报编辑(/en-us/citrix-analytics/media/pa-alert-overload-edit.png)
当在 15 分钟间隔内环境中检测到过载计算机时,会向管理员发送过载计算机警报邮件。
过载计算机警报(/en-us/citrix-analytics/media/pa-overload-alert.png)
如果机器持续处于过载状态,将生成重新警报邮件,
-
对于单会话机器,每 24 小时一次,
-
对于多会话机器,如果机器有新的会话且会话分数较低,则第一天最多三次,24 小时后一次。
警报邮件显示导致用户体验不佳的过载机器数量以及在选定持续时间内受影响的用户数量。
单击 查看机器 可在“过载机器”的“机器自助服务”页面中查看列出的过载机器。
检测到的模式 部分显示了在过载机器中观察到的前三种模式,这些模式基于以下标准:
-
每个交付组中的过载机器数量
-
运行单会话或多会话操作系统的过载机器数量
-
具有持续内存或 CPU 峰值的过载机器数量
查看最新见解 链接将引导至“用户体验”仪表板,其中显示了“见解”面板中的最新统计信息。
更新参数会改变过载机器诊断见解的计算方式。
有关详细信息,请参阅 见解 文章。
黑洞机器警报
Citrix Analytics for Performance 每 15 分钟扫描一次黑洞机器,并发出警报,使管理员能够主动缓解用户因黑洞机器而面临的会话故障。未能处理四个或更多连续会话请求的机器被称为黑洞机器。通过黑洞故障警报,管理员无需登录 Performance Analytics 即可了解因黑洞机器而发生的会话故障。
您可以自定义黑洞机器警报的警报条件和重新警报首选项。
有关机器及其导致的会话失败的详细信息会通过警报邮件发送给管理员。必须启用黑洞机器警报策略才能接收这些邮件。
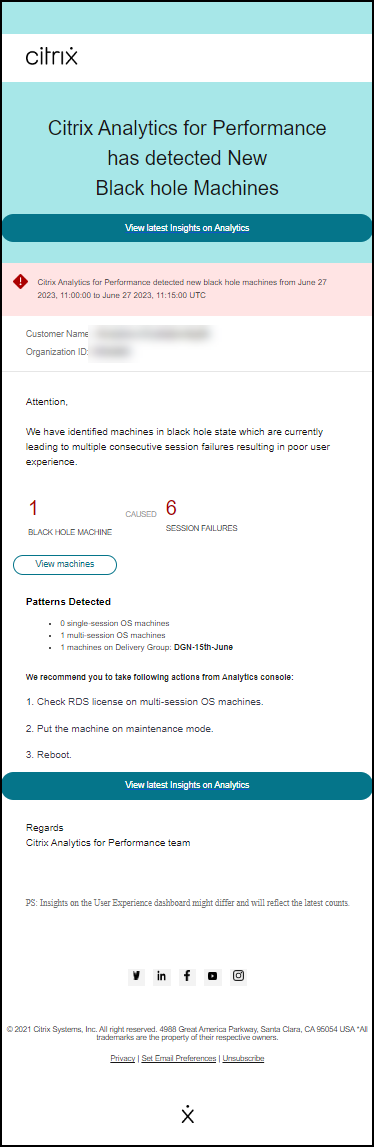
单击“查看机器”链接会转到“机器自助服务”视图,其中显示了 15 分钟间隔内黑洞机器的列表。此外,时间线视图会显示过去 24 小时内识别出的黑洞机器。 如果同一黑洞机器导致的会话失败次数在 24 小时内翻倍,并且重新警报首选项设置为已启用,则会再次向管理员发出警报。
“查看最新见解”链接会转到“用户体验”控制板,其中显示了“见解”面板中的最新统计信息。
检测到的模式部分显示了在黑洞机器中观察到的前三种模式,具体取决于以下条件:
-
每个交付组中的黑洞机器数量
-
运行单会话或多会话操作系统的黑洞机器数量
更新参数会更改黑洞机器诊断见解的计算。有关详细信息,请参阅见解文章。
会话失败警报
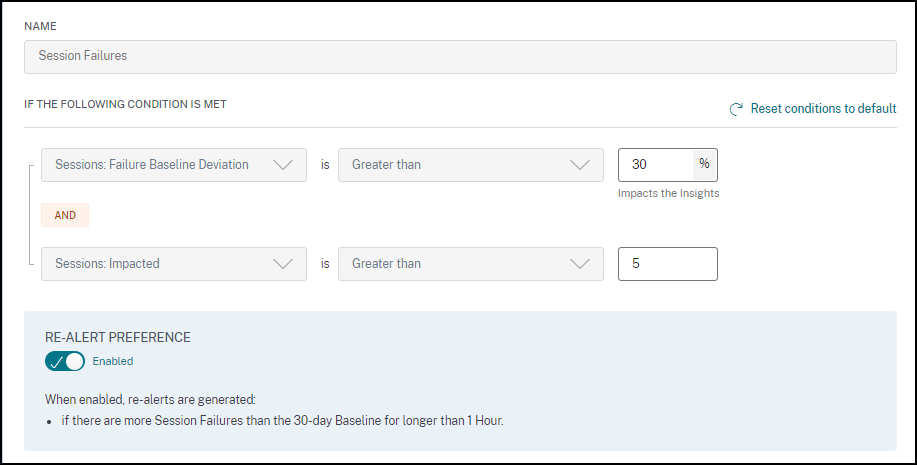
当未能启动的会话数量超出 30 天基线值 30% 或更多,并且失败的会话总数超过 5% 时,会生成会话失败警报。基线值是根据过去 30 天内同一时间段测量的会话失败计数的 P80 值计算得出的。
您可以自定义会话失败警报的警报条件和重新警报首选项。
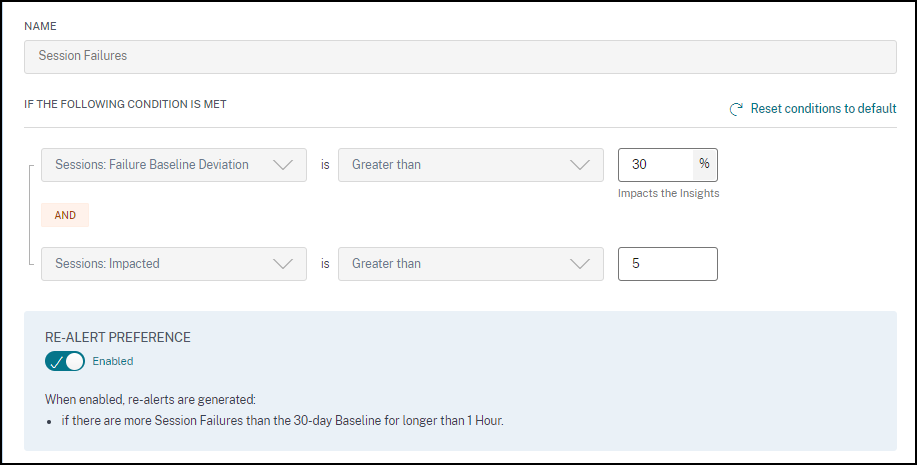
会话失败警报通知会发送给所有已配置的管理员。
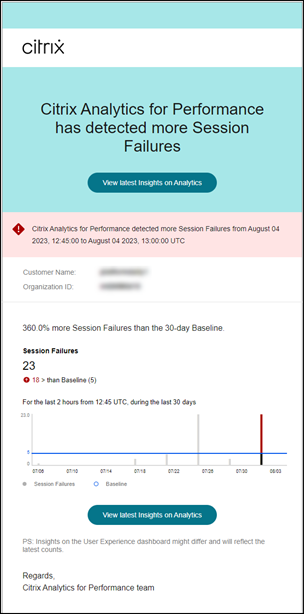
会话失败警报邮件显示以下信息:
-
当前会话失败计数与基线值相比的百分比变化
-
当前会话失败次数
-
相对于基线值的会话失败次数增加
-
显示过去 30 天内基线值和会话失败计数的图表。
“查看最新洞察”链接会跳转到用户体验仪表板,其中显示“基线洞察”面板中的最新统计信息。
更新参数会改变会话失败的基线洞察计算。有关更多信息,请参阅洞察文章。
响应能力差的会话警报
当响应能力差的会话数量比 30 天基线值增加 30% 或更多,并且此增加影响超过 5% 的会话时,会生成“响应能力差的会话”警报。基线值是根据过去 30 天内相同时间段内测量的响应能力差的会话数量的 P80 值计算得出的。
您可以自定义响应能力差的会话警报的警报条件和重新警报首选项。
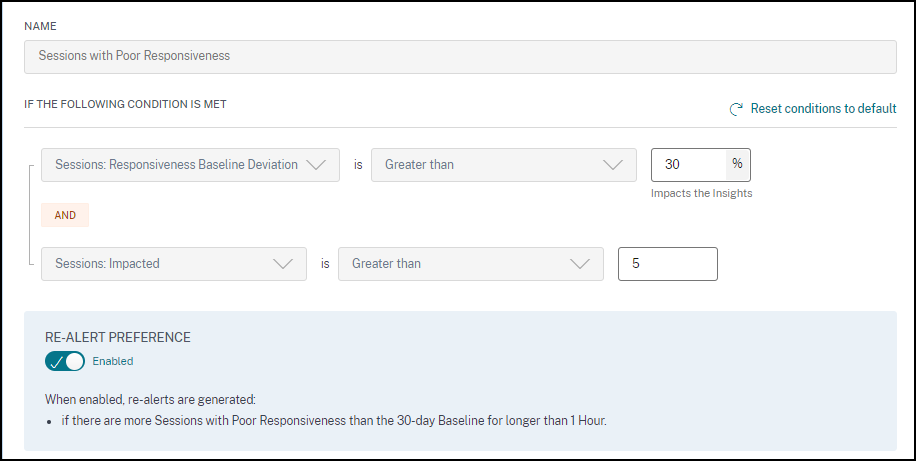
响应能力差的会话警报通知将发送给已配置的管理员。
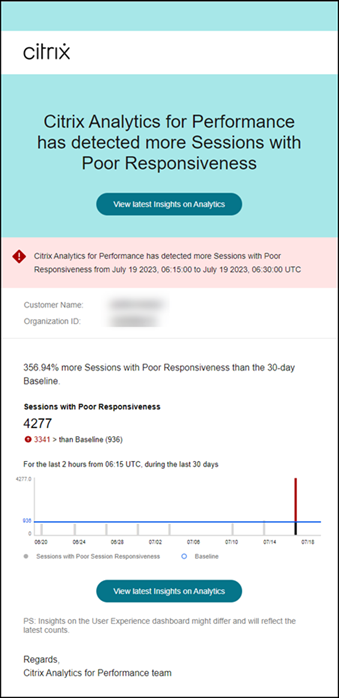
警报邮件包含以下信息:
-
当前响应能力差的会话数量值与基线值相比的百分比变化
-
当前响应能力差的会话数
-
相对于基线值,响应能力差的会话的增加或减少
-
显示基线值和过去 30 天响应能力差的会话数趋势的图表。
“查看最新洞察”链接会转到“用户体验”仪表板,其中显示“洞察”面板中的最新统计信息。
更新参数会更改响应能力差的会话的基线洞察的计算。有关详细信息,请参阅洞察文章。
登录持续时间差的会话警报
当登录持续时间差的会话数比 30 天基线值增加 30% 或更多,并且此增加影响超过 5% 的会话时,会生成“登录持续时间差的会话”警报。基线值是根据过去 30 天内同一时间段测量的登录持续时间差的会话数的 P80 值计算的。
您可以自定义“登录持续时间差的会话”警报的警报条件和重新警报首选项。
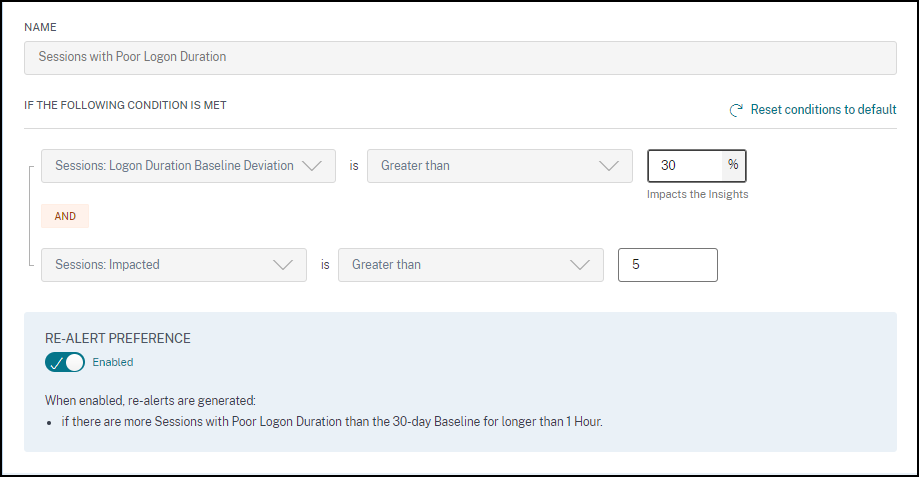
登录持续时间差的会话警报通知将通过邮件发送给已配置的管理员。
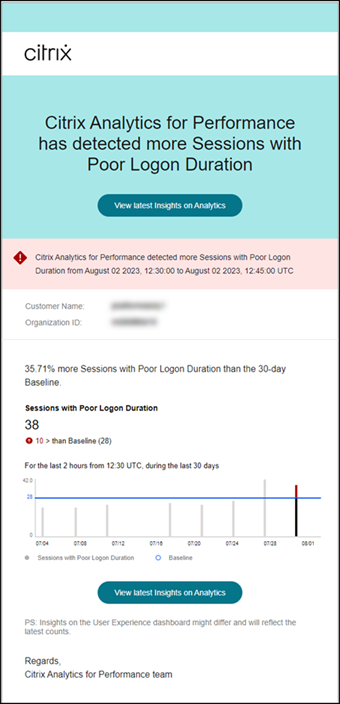
登录持续时间差的会话警报邮件显示以下信息:
-
当前登录持续时间差的会话数与基线值相比的百分比变化
-
当前登录持续时间差的会话数
-
相对于基线值,登录持续时间差的会话的增加或减少
-
显示基线值和过去 30 天内登录持续时间较差的会话数的图表
“查看最新洞察”链接会转到“用户体验”控制板,其中显示“基线洞察”面板中的最新统计信息。
有关详细信息,请参阅洞察文章。
异常会话断开连接警报
当会话断开连接计数比 30 天基线值增加 30% 或更多,并且此增加影响超过 5% 的会话时,将生成“异常会话断开连接”警报。基线值计算为过去 30 天内同一时间段测量的会话断开连接数的 P80 值。
您可以自定义异常会话断开连接警报的警报条件和重新警报首选项。
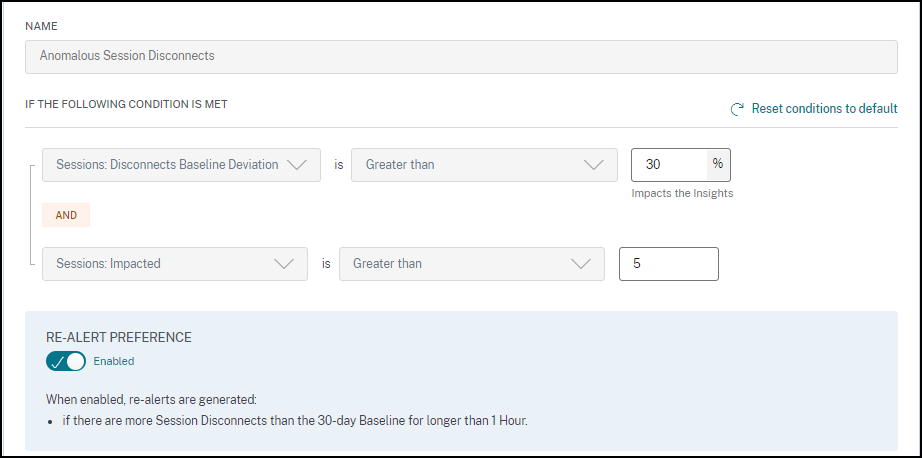
登录持续时间较差的会话警报通知将发送给已配置的管理员。
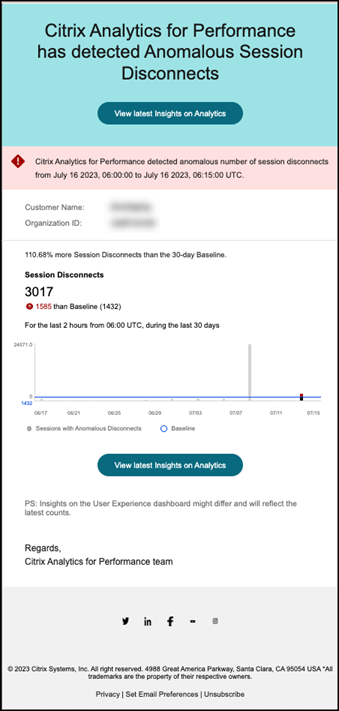
异常会话断开连接警报邮件显示以下信息:
-
当前会话断开连接计数与基线值相比的百分比变化
-
当前会话断开连接数
-
相对于基线值的会话断开连接增加量
-
显示基线值和过去 30 天内会话断开连接数的图表。
“查看最新洞察”链接会转到“用户体验”控制板,其中显示“基线洞察”面板中的最新统计信息。
更新参数会改变异常会话断开连接的基线洞察的计算方式。欲了解更多信息,请参阅洞察文章。