
Citrix Analyticsアドオンアプリケーションを使用したSplunkアーキテクチャ
Splunkは、以下の3つの層を含むアーキテクチャを採用しています。
-
コレクション
-
インデックス作成
-
検索
Splunkは、データをSplunkに簡単に取り込み、インデックス化して検索可能にするための幅広いデータ収集メカニズムをサポートしています。この層は、ヘビーフォワーダーまたはユニバーサルフォワーダーに他なりません。
アドオンアプリケーションは、ユニバーサルフォワーダー層ではなく、ヘビーフォワーダー層にインストールする必要があります。なぜなら、構造化されたデータ(json、csv、tsvなど)のいくつかの例外を除いて、ユニバーサルフォワーダーはログソースをイベントに解析しないため、ログの形式を理解する必要があるアクションを実行できないからです。
また、Pythonの簡易版が付属しているため、完全なSplunkスタックを必要とするモジュラー入力アプリケーションとは互換性がありません。ヘビーフォワーダーは、コレクション層に他なりません。
ユニバーサルフォワーダーとヘビーフォワーダーの主な違いは、ヘビーフォワーダーが完全な解析パイプラインを含み、実際にディスクにイベントを書き込んだりインデックスを作成したりすることなく、インデクサーが実行するのと同じ機能を実行することです。これにより、ヘビーフォワーダーは、データマスキング、フィルタリング、イベントデータに基づくルーティングなど、個々のイベントを理解し、それに基づいて動作することができます。アドオンアプリケーションは完全なSplunk Enterpriseインストールであるため、適切なデータ収集のために完全なPythonスタックを必要とするモジュラー入力をホストしたり、Splunk HTTP Event Collector (HEC) のエンドポイントとして機能したりできます。
データが収集されると、インデックス化または処理され、検索可能になるように保存されます。
顧客がデータを探索する主な方法は検索です。検索はレポートとして保存し、ダッシュボードパネルの作成に利用できます。検索はデータから情報を抽出するものです。
一般的に、Splunkアドオンアプリケーションはコレクション層(Splunk Enterpriseレベル)にデプロイされ、当社のダッシュボードアプリケーションは検索層(Splunk Cloudレベル)にデプロイされます。シンプルなオンプレミス設定では、これら3つの層すべてを単一のSplunkホストに配置できます(シングルサーバーデプロイメントとして知られています)。
コレクション層は、Splunk用アドオンアプリケーションを使用するのに非常に優れた方法です。アドオンアプリケーションをインストールする方法は2つあります。顧客環境下のコレクション層にインストールするか、Splunk Cloudインスタンス下の入力データマネージャーにインストールするかのいずれかです。
当社のアドオンアプリケーションを使用したSplunkデプロイメントアーキテクチャを理解するには、以下の図を参照してください。
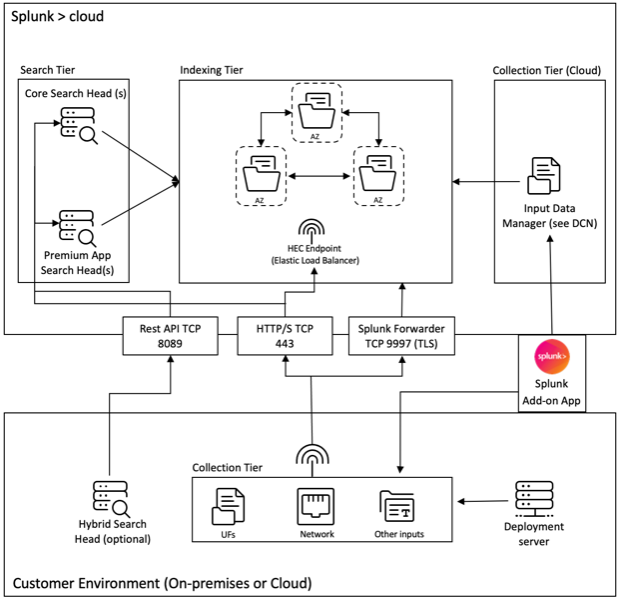
前述の図に示されているインプットデータマネージャー (IDM) は、スクリプト化された入力とモジュラー入力のみをサポートするデータ収集ノード (DCN) のSplunk Cloud管理による実装です。それ以上のデータ収集のニーズには、Splunkのヘビーフォワーダーを使用して環境にDCNをデプロイして管理できます。
Splunkは、さまざまなソースからデータを収集、インデックス作成、検索することを可能にします。データを収集する1つの方法はAPIを介することであり、これによりSplunkは他のシステムやアプリケーションに保存されているデータにアクセスできます。これらのAPIには、クエリメカニズムとしてREST、Webサービス、JMS、および/またはJDBCを含めることができます。Splunkおよびサードパーティの開発者は、Splunkモジュラー入力フレームワークを介したAPIインタラクションを可能にするさまざまなアプリケーションを提供しています。これらのアプリケーションは通常、適切に機能するために完全なSplunk Enterpriseソフトウェアのインストールを必要とします。
APIを介したデータ収集を容易にするために、DCNとしてヘビーフォワーダーをデプロイするのが一般的です。ヘビーフォワーダーは、完全な解析パイプラインを含み、個々のイベントを理解して処理できるため、ユニバーサルフォワーダーよりも強力なエージェントです。これにより、APIを介してデータを収集し、Splunkインスタンスに転送してインデックス作成する前に処理することができます。
Splunk Cloudデプロイメントのハイレベルアーキテクチャの詳細については、Splunk Validated Architecturesを参照してください。