
Alertas e notificações
Os alertas são exibidos no Monitor no painel e em outras visualizações de alto nível com símbolos de alerta de aviso e crítico. Os alertas são atualizados automaticamente a cada minuto; você também pode atualizar os alertas sob demanda.
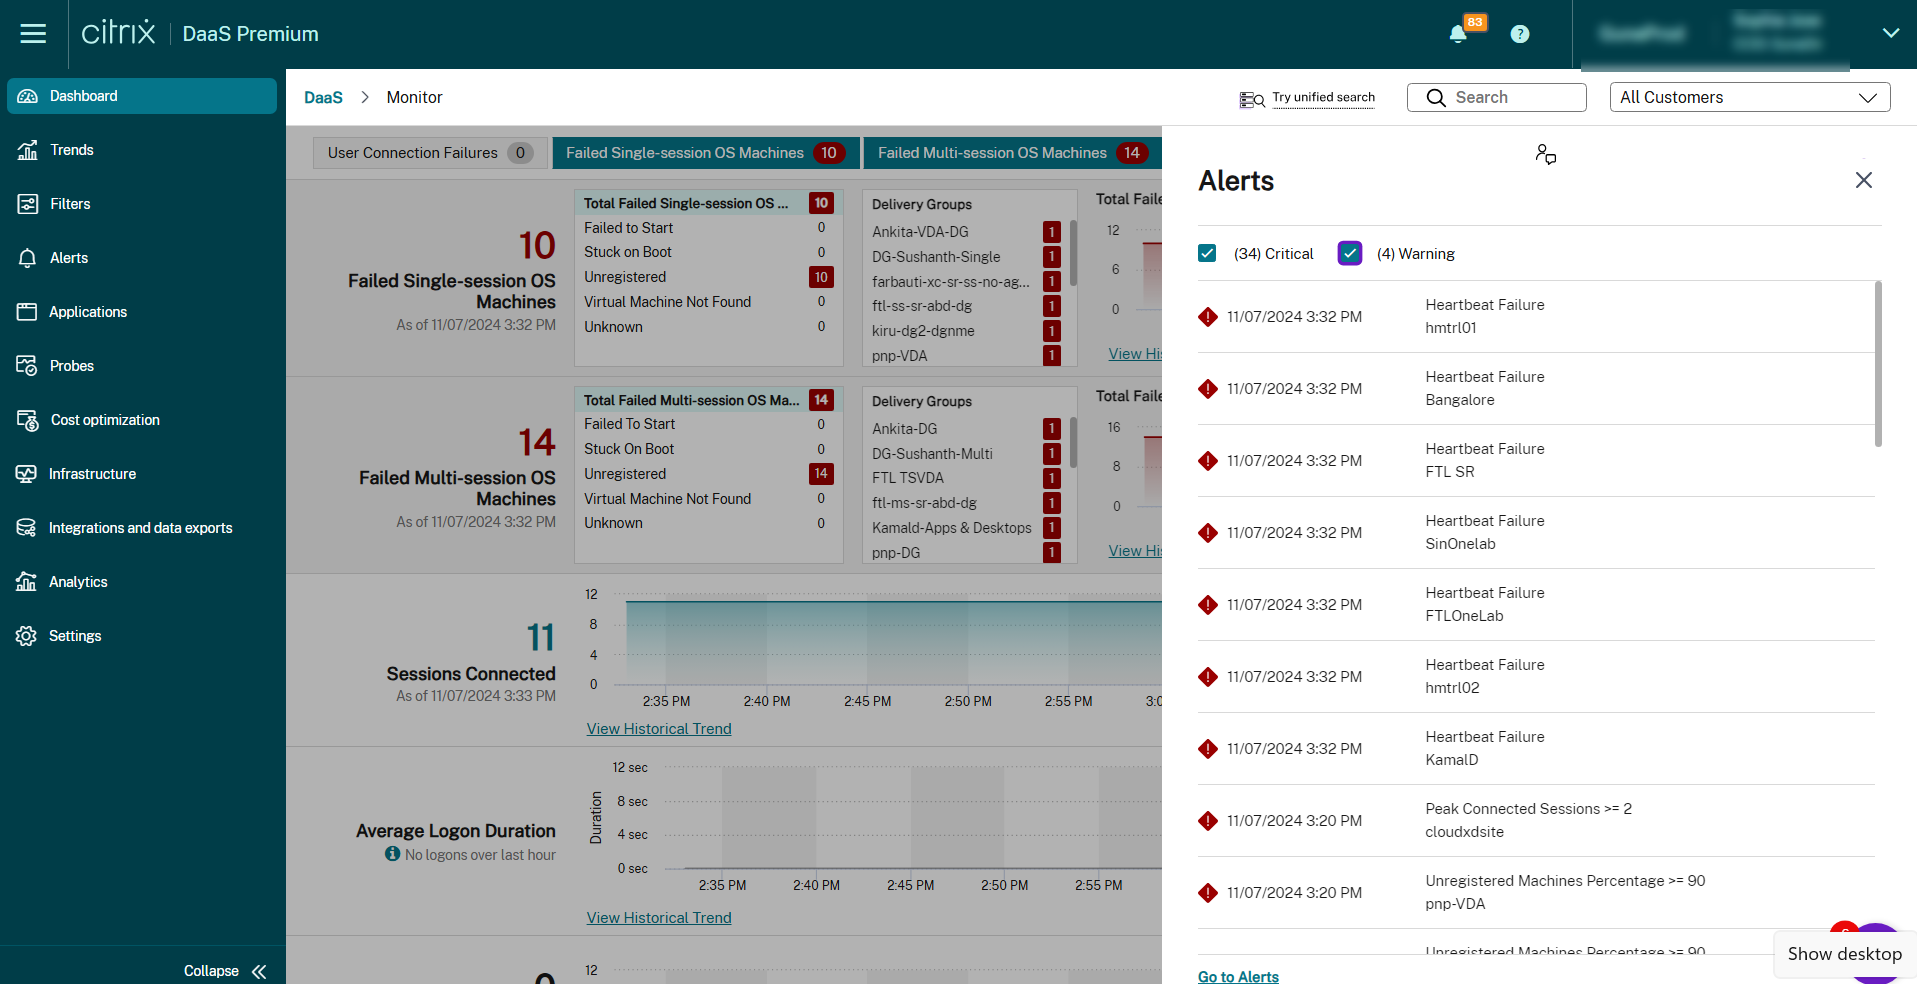
Um alerta de aviso (triângulo âmbar) indica que o limite de aviso de uma condição foi atingido ou excedido.
Um alerta crítico (círculo vermelho) mostra que o limite crítico de uma condição foi atingido ou excedido.
Você pode visualizar informações mais detalhadas sobre os alertas selecionando um alerta na barra lateral, clicando no link Ir para Alertas na parte inferior da barra lateral ou selecionando Alertas na parte superior da página Monitor.
Na visualização Alertas, você pode filtrar e exportar alertas. Por exemplo, máquinas Multi-session OS com falha para um grupo de entrega específico no último mês, ou todos os alertas para um usuário específico. Para obter mais informações, consulte Exportar relatórios.
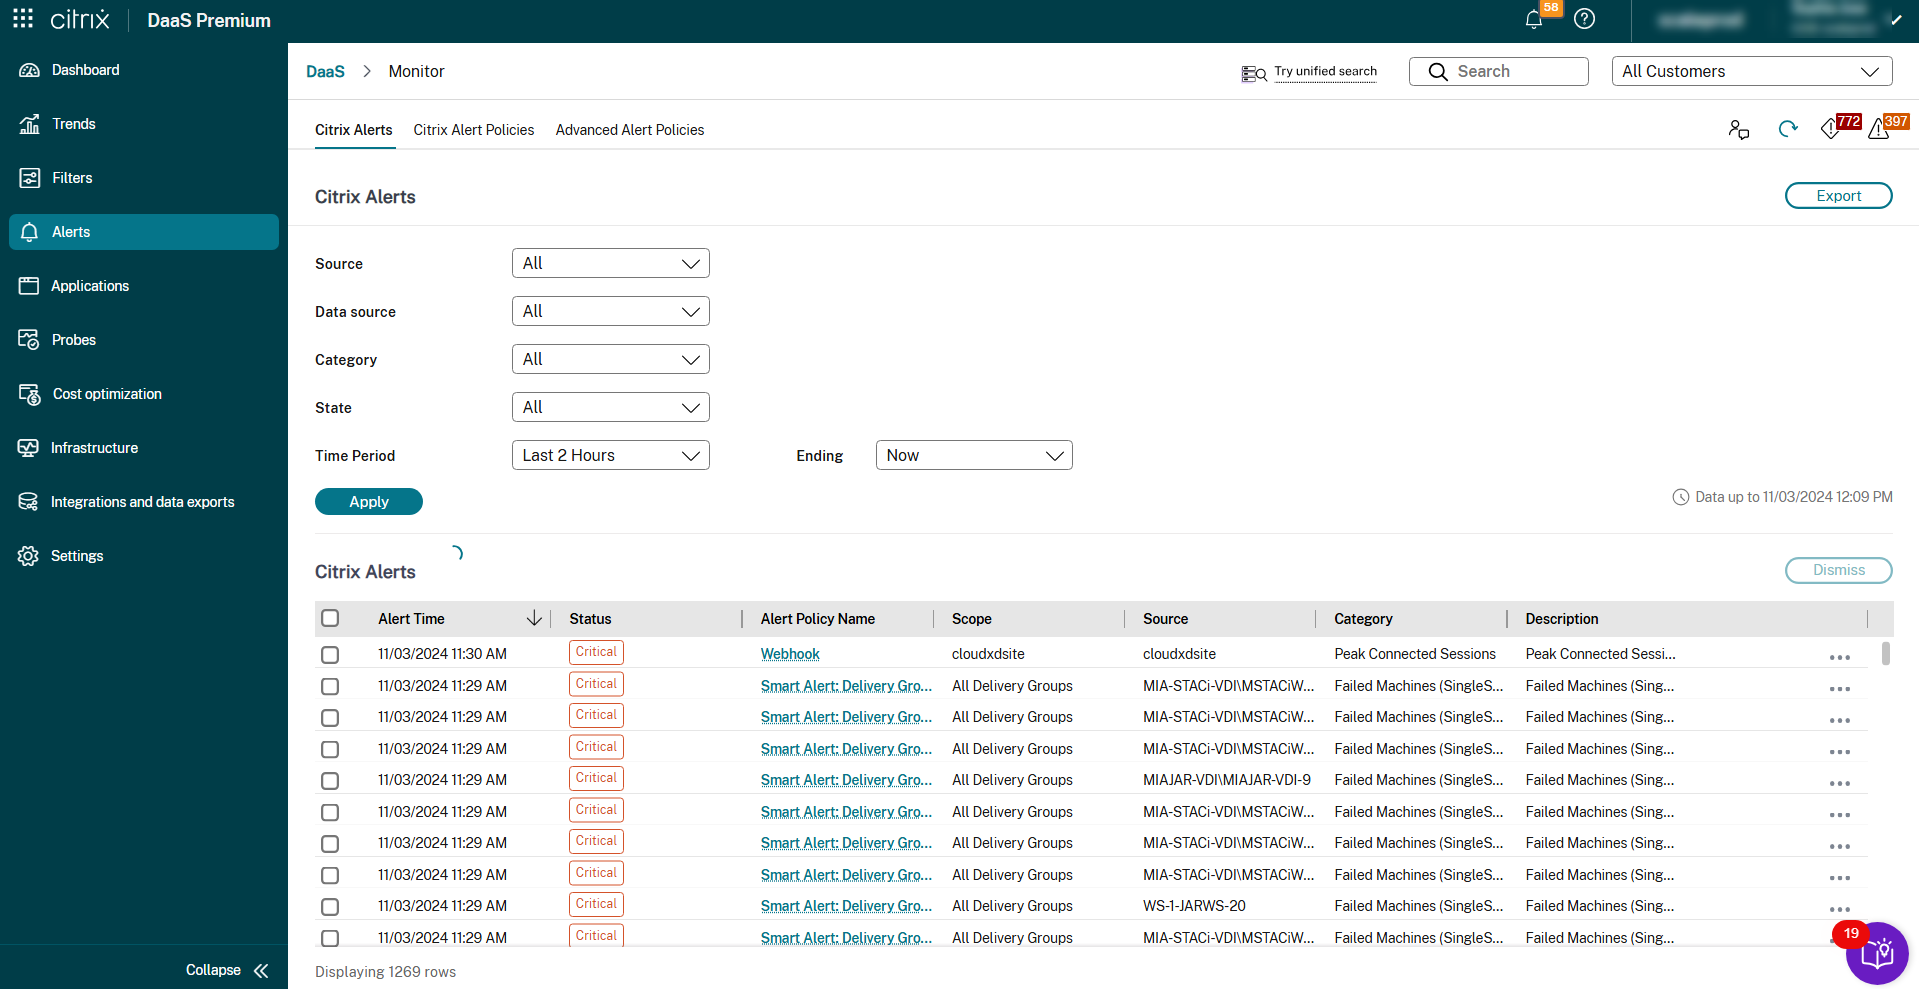
Alertas Citrix®
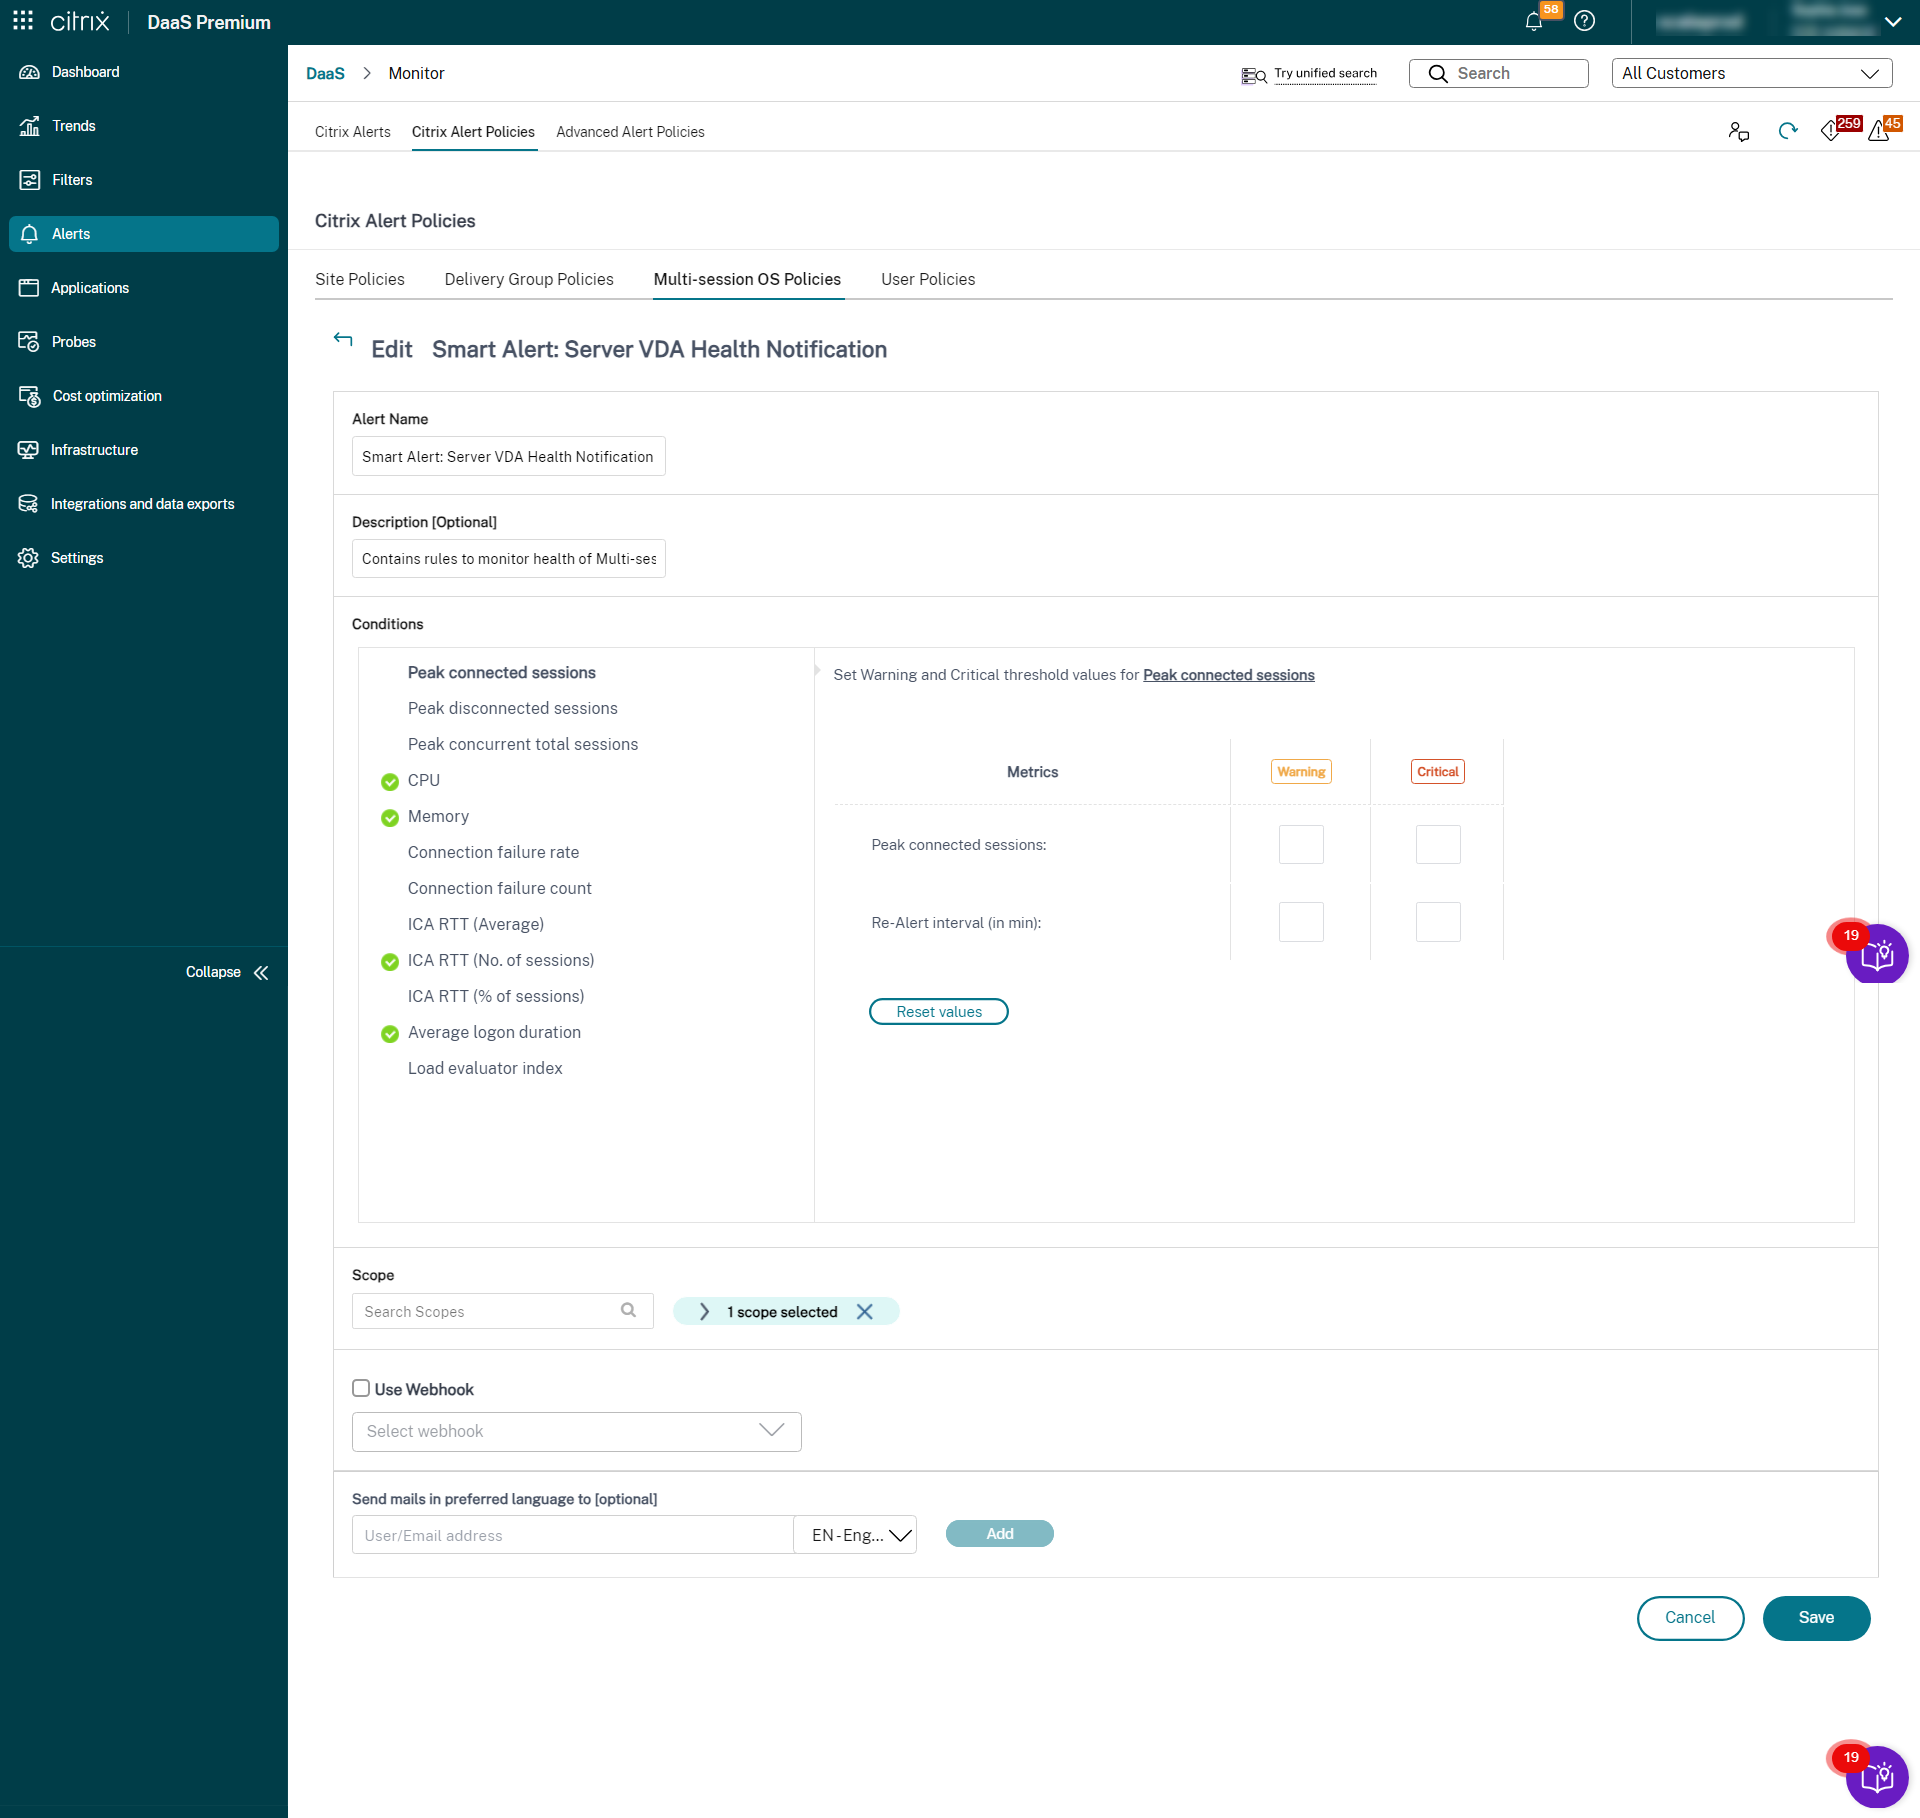
Os alertas Citrix são aqueles que se originam dos componentes Citrix. Você pode configurar alertas Citrix dentro do Monitor em Alertas \> Política de Alertas Citrix. Como parte da configuração, você pode definir notificações a serem enviadas por e-mail para indivíduos e grupos quando os alertas excederem os limites que você configurou. Para obter mais informações sobre como configurar Alertas Citrix, consulte Criar políticas de alerta.
Políticas de alerta inteligentes
Um conjunto de políticas de alerta integradas com valores de limite predefinidos está disponível para grupos de entrega e escopo de VDAs de SO de múltiplas sessões. Você pode modificar os parâmetros de limite das políticas de alerta integradas em Alertas \> Política de Alertas Citrix. Essas políticas são criadas quando há pelo menos um destino de alerta — um grupo de entrega ou um VDA de SO de múltiplas sessões definido em seu site. Além disso, esses alertas integrados são adicionados automaticamente a um novo grupo de entrega ou a um VDA de SO de múltiplas sessões.
As políticas de alerta integradas são criadas somente se nenhuma regra de alerta correspondente existir no banco de dados do Monitor.
Para os valores de limite das políticas de alerta integradas, consulte a seção Condições das políticas de alerta.
Políticas de alerta avançadas
O recurso de Notificação e Alerta Proativo do Monitor foi aprimorado para incluir uma nova estrutura de alerta chamada Políticas de Alerta Avançadas. Com esse recurso, você pode criar alertas incluindo detalhes granulares para cada elemento ou condição, aumentando assim o controle sobre o escopo dos alertas. Atualmente, essas políticas incluem alertas para economia de custos e infraestrutura.
Com a introdução das políticas de alerta avançadas, que são alertas orientados por fonte de dados, você pode usar a filtragem de escopo de múltiplas condições.
Esse recurso ajuda a reduzir alertas excessivos que podem levar à diminuição da capacidade de resposta ou eficácia na resolução de problemas importantes. Essa política ajuda a medir a eficácia das políticas de alerta e o engajamento dos administradores.
Você pode criar uma política de alerta avançada na seção Alertas > Política de alerta avançada > Criar Política. Você pode selecionar uma das seguintes Fontes de dados:
-
Máquinas
-
Serviço de Provisionamento
-
StoreFront™
Alertas para economia de custos
Você pode criar alertas para economia de custos, o que ajuda a otimizar os custos. Atualmente, você pode criar alertas para máquinas.
Para criar alertas em Máquinas, faça o seguinte:
-
Clique na guia Alertas > Políticas de Alerta Avançadas. A página Políticas de Alerta Avançadas é exibida.
-
Clique em Criar Política. A seção Criar Políticas de Alerta Avançadas é exibida.
-
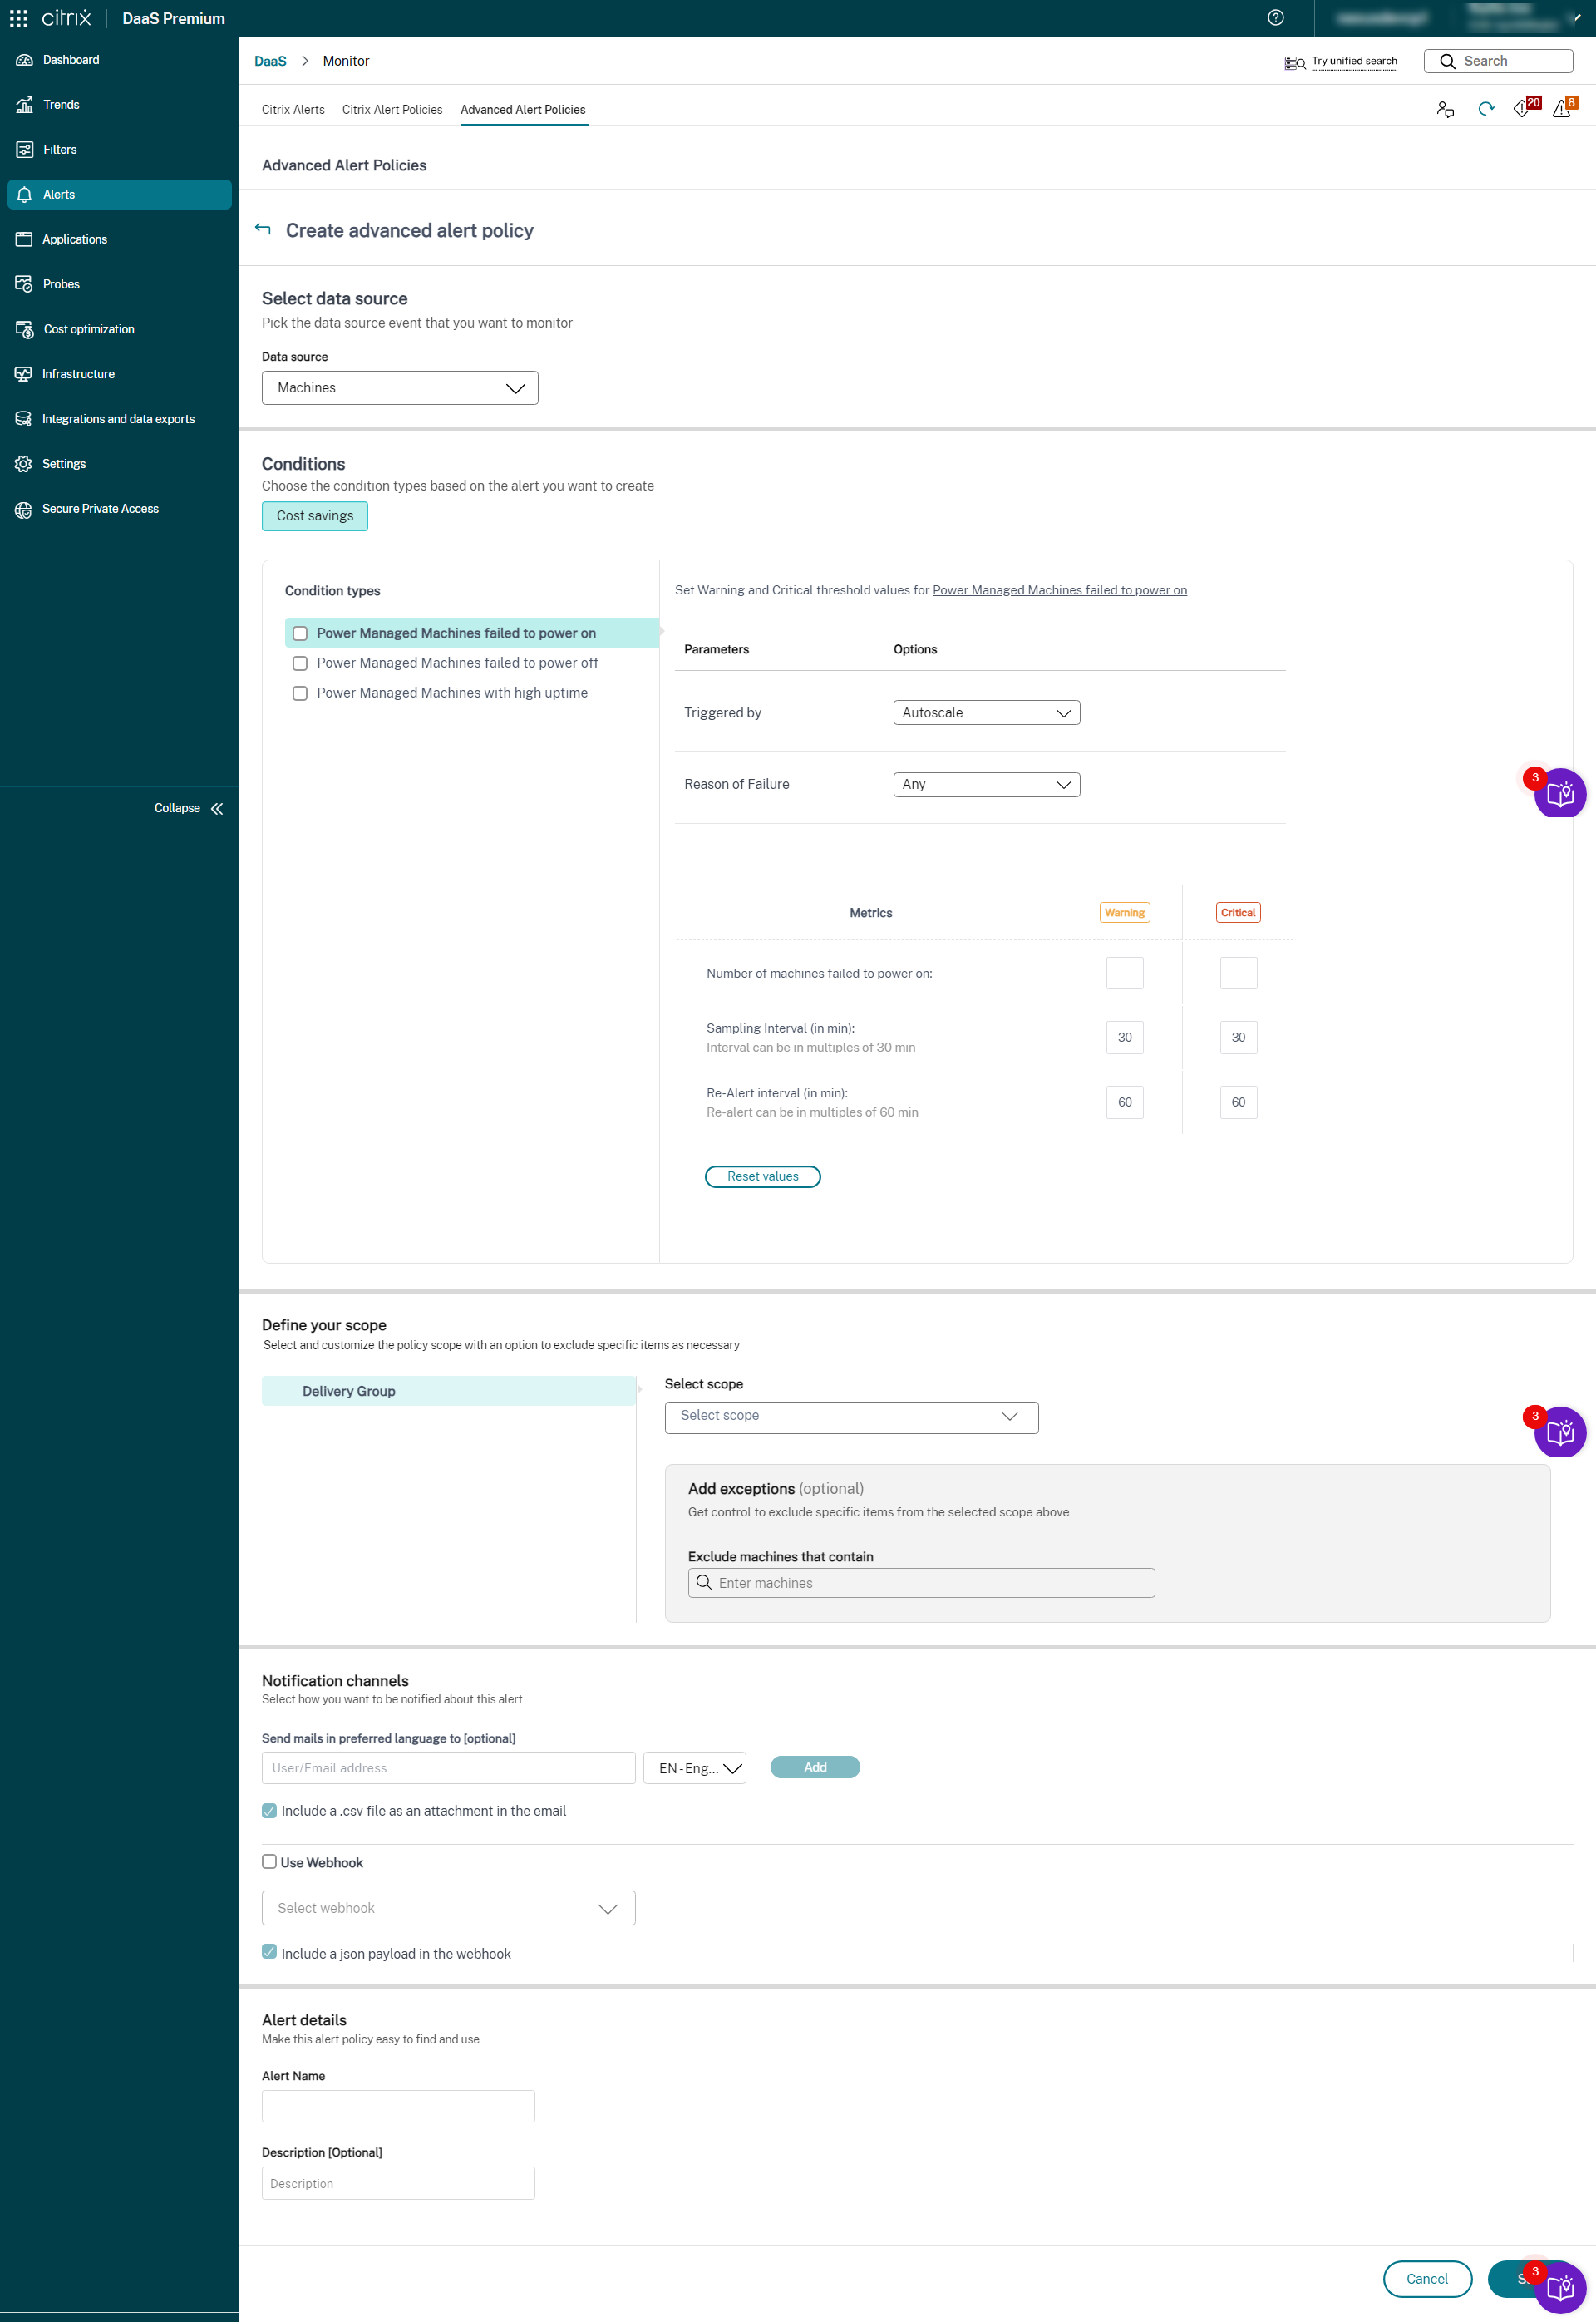
Selecione Máquinas na lista suspensa Fonte de dados. A condição de Economia de custos e os tipos de condição correspondentes são exibidos.
-
Selecione os seguintes tipos de condição conforme necessário:
-
Máquinas com gerenciamento de energia falharam ao ligar
-
Máquinas com gerenciamento de energia falharam ao desligar
-
Máquinas com gerenciamento de energia com alto tempo de atividade
-
-
Selecione os parâmetros específicos e as opções correspondentes para cada uma das condições selecionadas.
-
Defina as métricas de Aviso e Crítico para o tipo de condição selecionado:
-
Para Máquinas com gerenciamento de energia com alto tempo de atividade:
-
Número de máquinas que excedem o limite de tempo de atividade
-
Intervalo de re-alerta (em min) o intervalo pode ser de no mínimo 60 min
-
-
Para Máquinas com gerenciamento de energia falharam ao ligar e Máquinas com gerenciamento de energia falharam ao desligar:
-
Número de máquinas que excedem o limite de tempo de atividade
-
Intervalo de amostragem (em min) os intervalos podem ser múltiplos de 30 min
-
Intervalo de re-alerta (em min) o re-alerta pode ser múltiplos de 60 min
-
-
-
Agende intervalos de re-alerta para os alertas selecionados conforme necessário.
-
Defina o escopo do alerta.
-
Defina os canais de notificação. Isso pode ser e-mail ou Webhook.
-
Você pode selecionar as seguintes caixas de seleção:
-
Incluir um payload JSON como anexo no webhook
-
Incluir um arquivo CSV como anexo no e-mail
-
-
-
Insira os Detalhes do alerta, como Nome do alerta e Descrição (opcional).
-
Clique em Salvar. O alerta é criado.
Alertas para Latência de Conexão SPA
A estrutura de Políticas de Alerta Avançadas oferece suporte a alertas proativos para conectividade de Acesso Privado Seguro (SPA). Use esta política para detectar e agir sobre a latência de ponta a ponta que afeta as conexões de usuário do SPA.
Configurar alerta de Latência de Conexão SPA
Para criar alertas para Latência de Conexão SPA, faça o seguinte:
-
Clique na guia Alertas > Políticas de Alerta Avançadas. A página Políticas de Alerta Avançadas é exibida.
-
Clique em Criar Política. A seção Criar Políticas de Alerta Avançadas é exibida.
-
Selecione Acesso Privado Seguro na lista suspensa Fonte de dados. A condição Latência de Conexão SPA é exibida.
-
Selecione os seguintes tipos de métrica conforme necessário:
-
Latência do ISP (Cliente → CDN)
-
Latência de conexão (Cliente → PoP do Gateway)
-
-
Latência do ISP (Cliente → CDN)
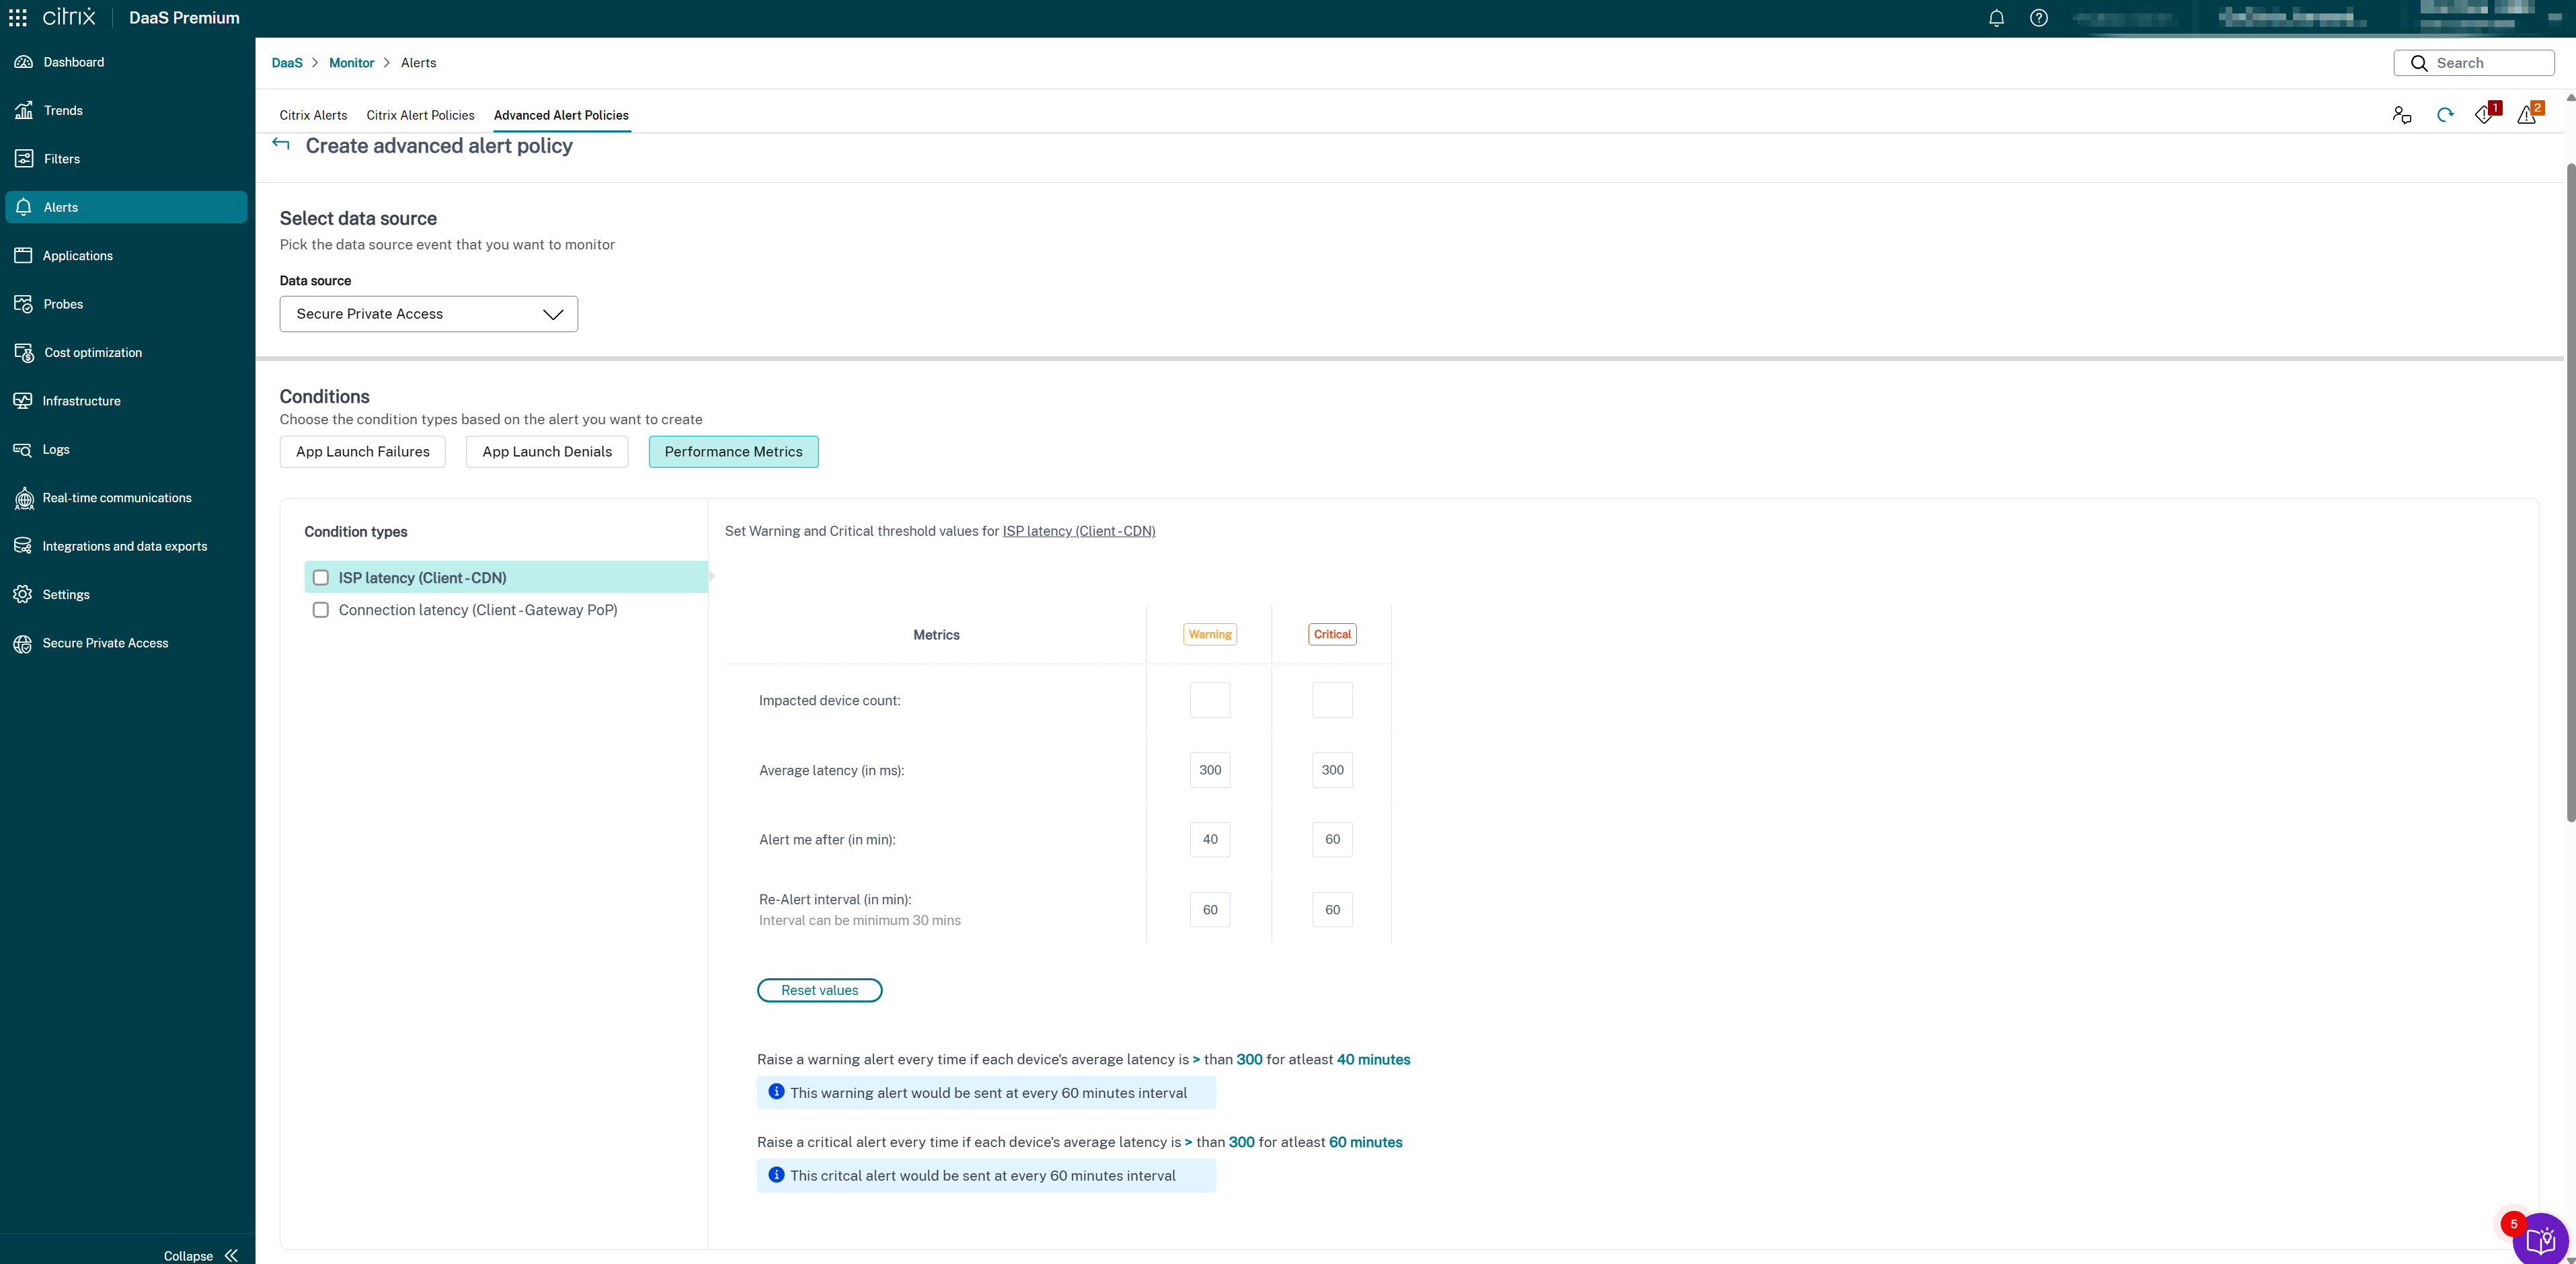
-
Latência de conexão (Cliente → PoP do Gateway)
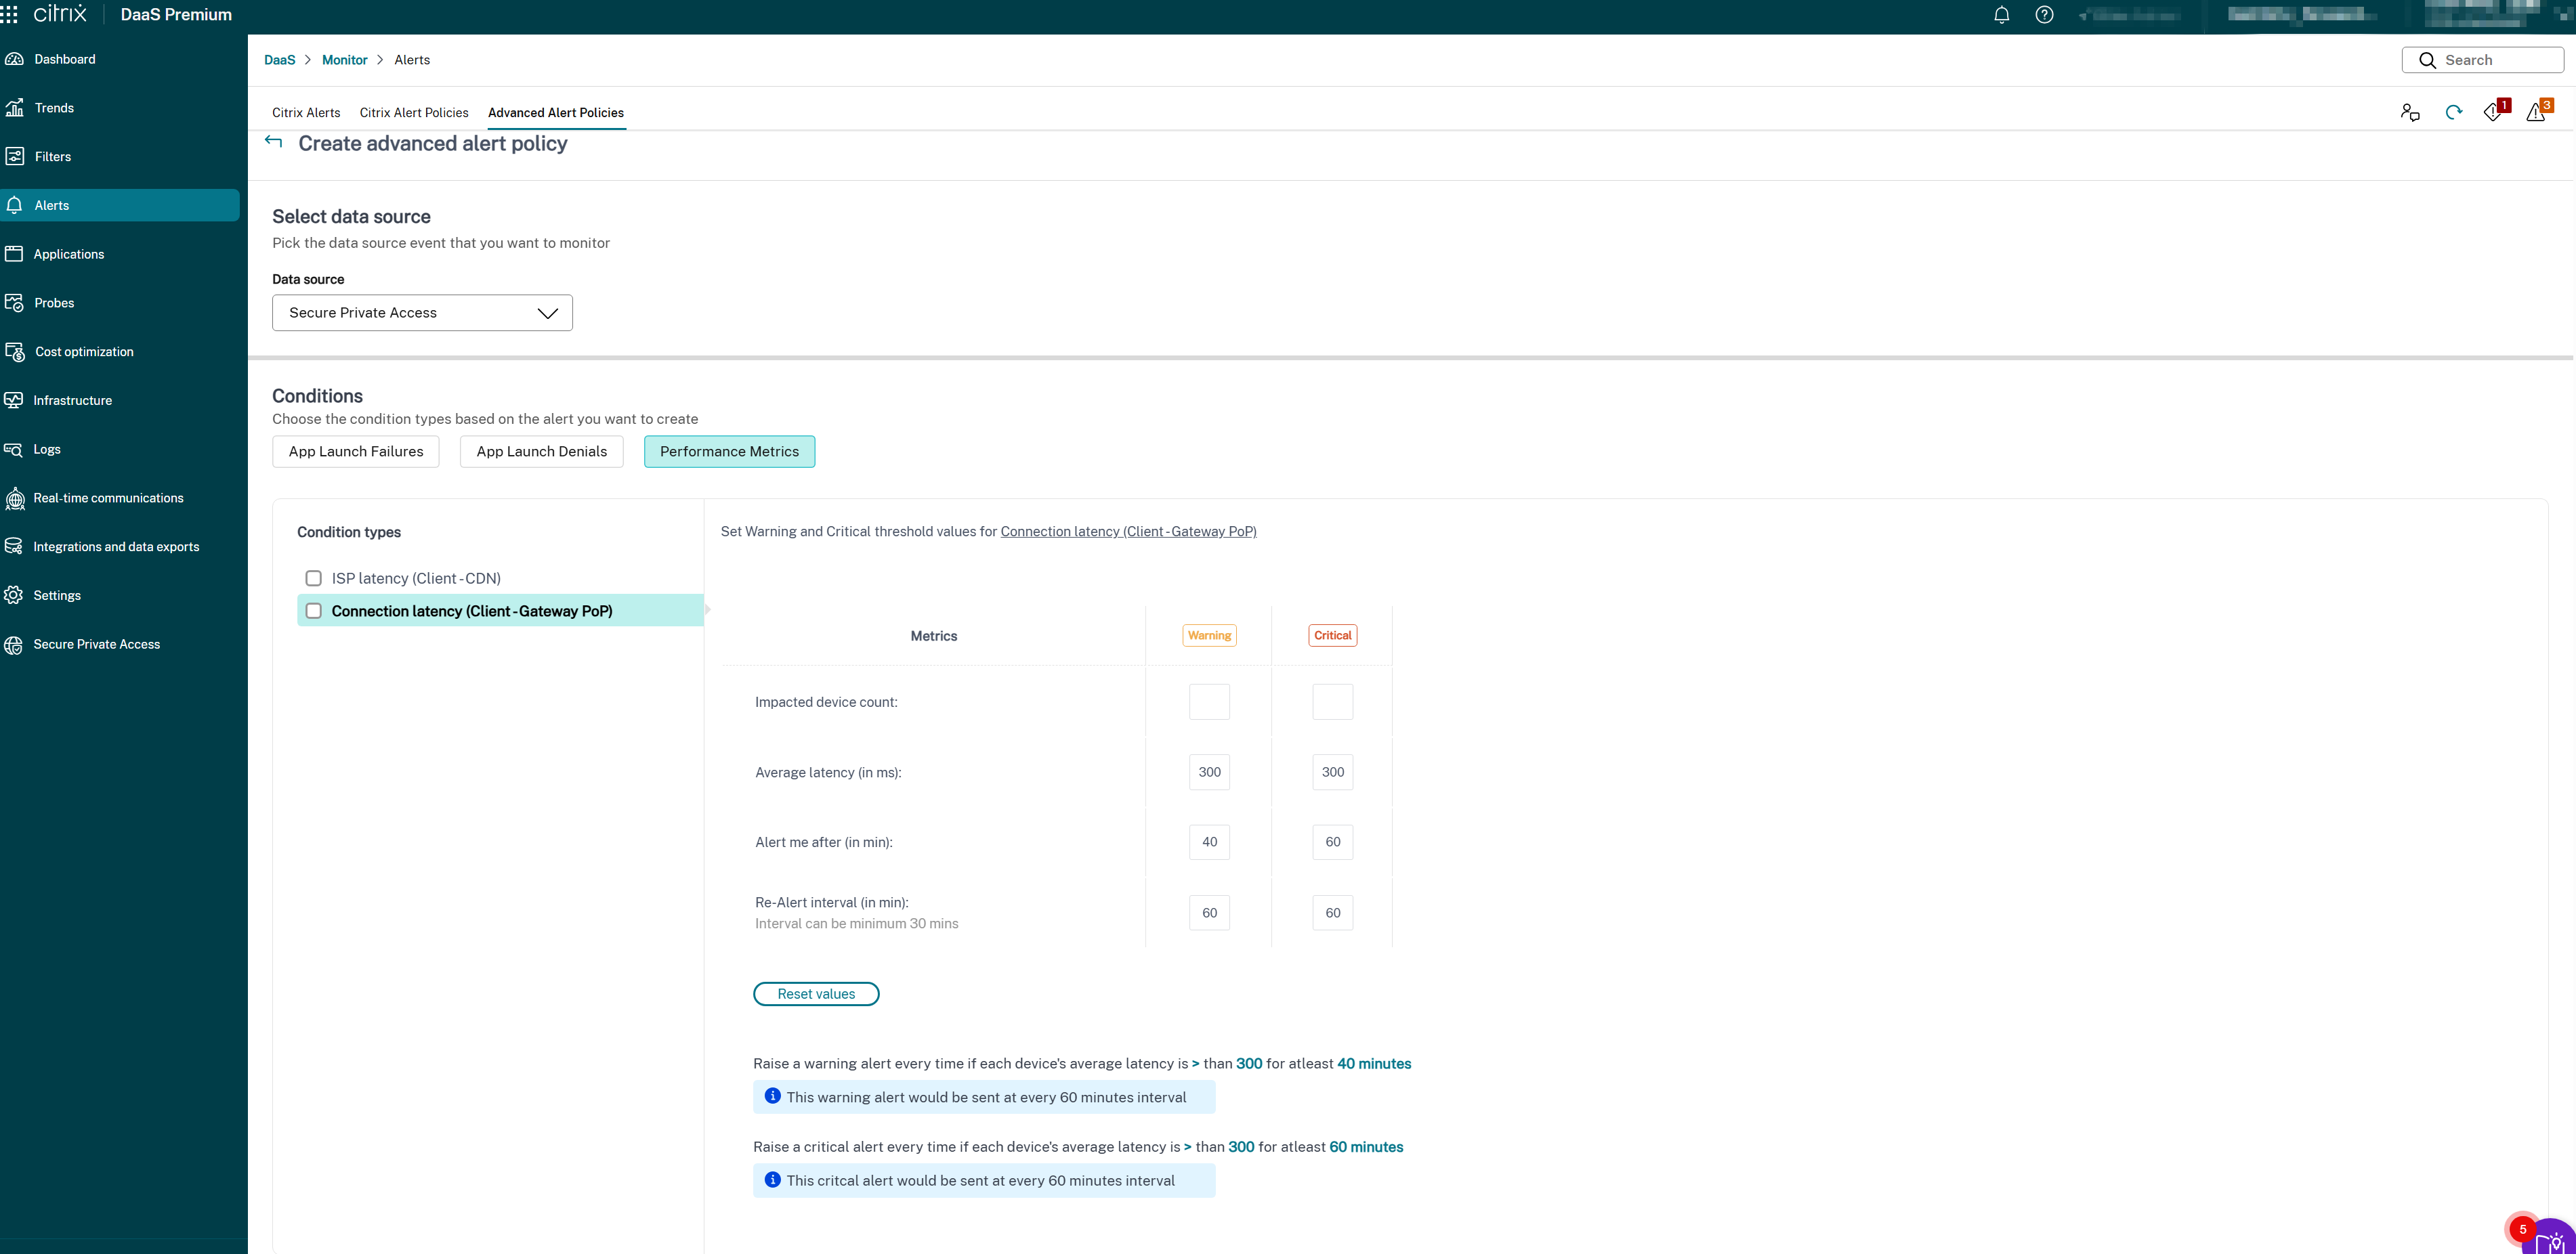
-
Selecione os parâmetros específicos e as opções correspondentes para cada uma das métricas selecionadas.
-
Defina as métricas de Aviso e Crítico para o tipo de condição selecionado:
-
Limite de latência (em ms): Defina os valores de Aviso (por exemplo, 150–200 ms) e Crítico (por exemplo, 300–400 ms)
-
Usuários impactados (contagem): Número de usuários com latência acima do limite
-
Intervalo de amostragem (em min): Com que frequência avaliar a latência (por exemplo, 5–15 minutos)
-
Intervalo de re-alerta (em min): Mínimo de 60 minutos recomendado para evitar fadiga de alerta
-
-
Agende intervalos de re-alerta para os alertas selecionados conforme necessário.
-
Defina o escopo do alerta. Selecione site, grupo de entrega ou subconjunto direcionado.
-
Defina os canais de notificação. Isso pode ser e-mail ou Webhook.
-
Você pode selecionar as seguintes caixas de seleção:
-
Incluir um payload JSON como anexo no webhook
-
Incluir um arquivo CSV como anexo no e-mail
-
-
-
Insira os detalhes do alerta, como Nome do Alerta (por exemplo, "Latência de Conexão SPA – PoP Leste") e Descrição (opcional).
-
Clique em Salvar. O alerta é criado.
Recomendação:
Para alertas proativos, ajuste os limites de latência com base nas medições de linha de base por região. Inclua a integração de webhook para encaminhar alertas de alta latência para o gerenciamento de incidentes para uma triagem mais rápida.
Políticas de infraestrutura
Você pode criar alertas para monitorar a integridade dos seguintes componentes do Citrix DaaS™ suportados:
-
Serviço de Provisionamento
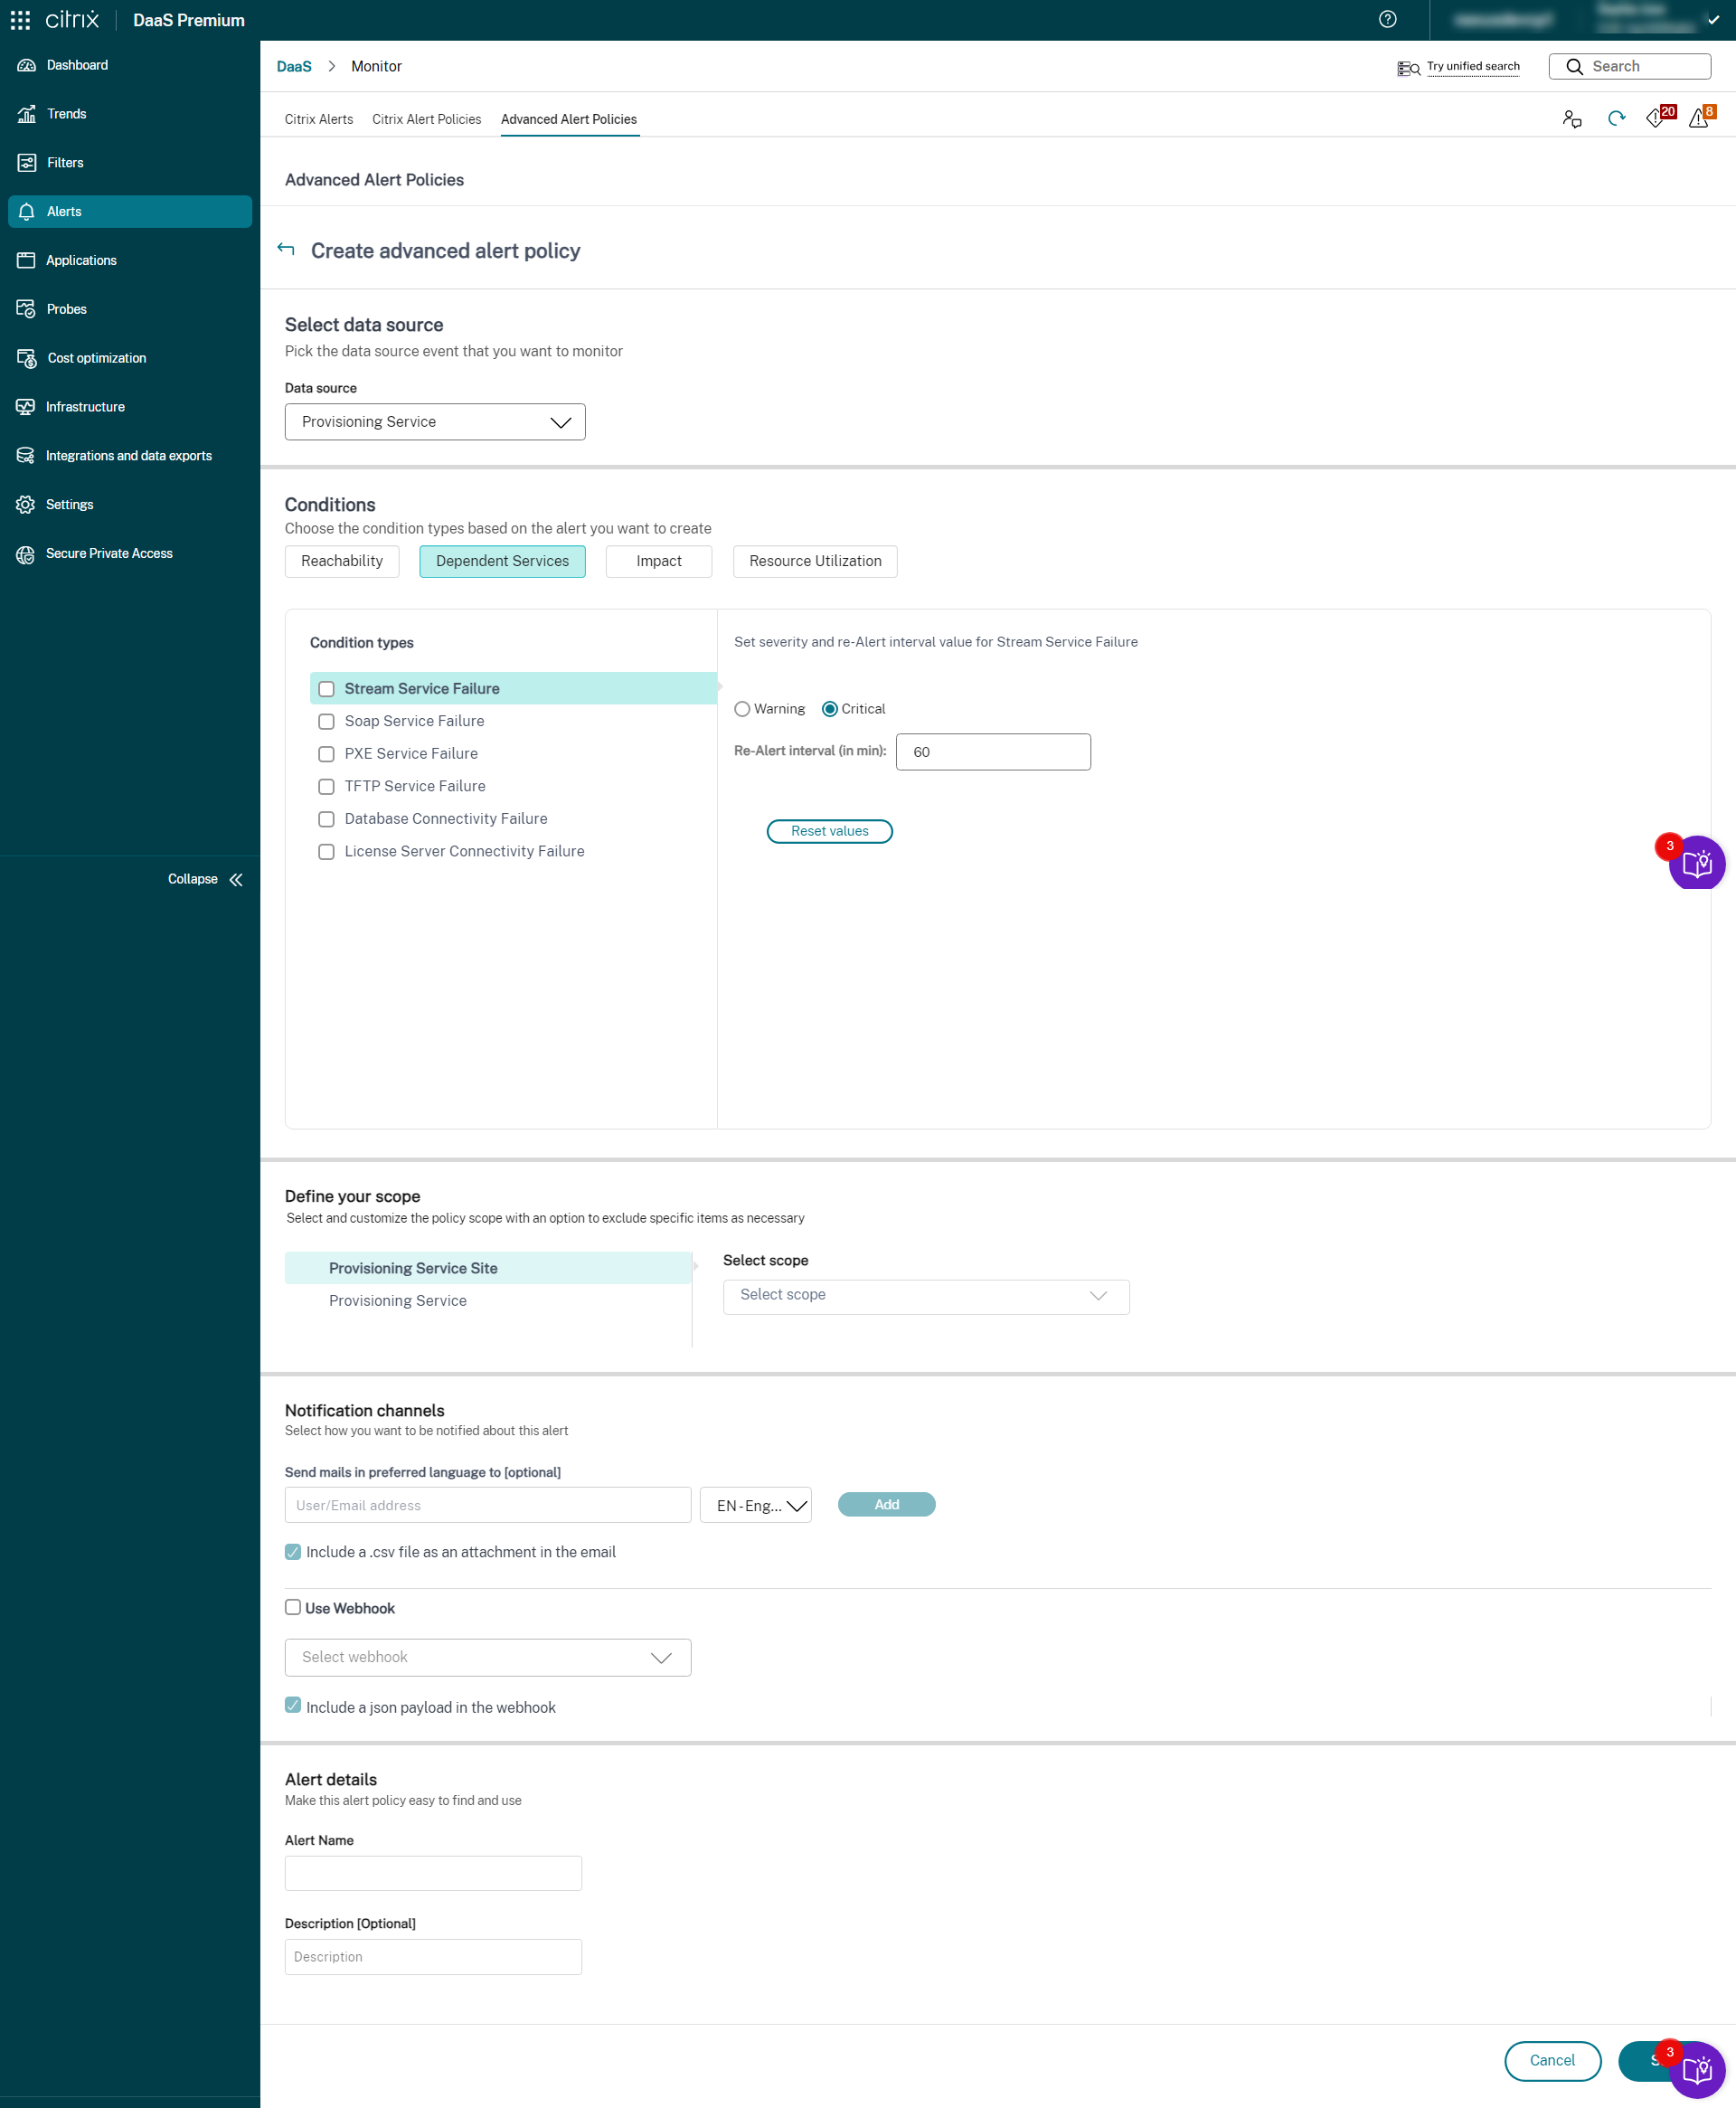
-
StoreFront
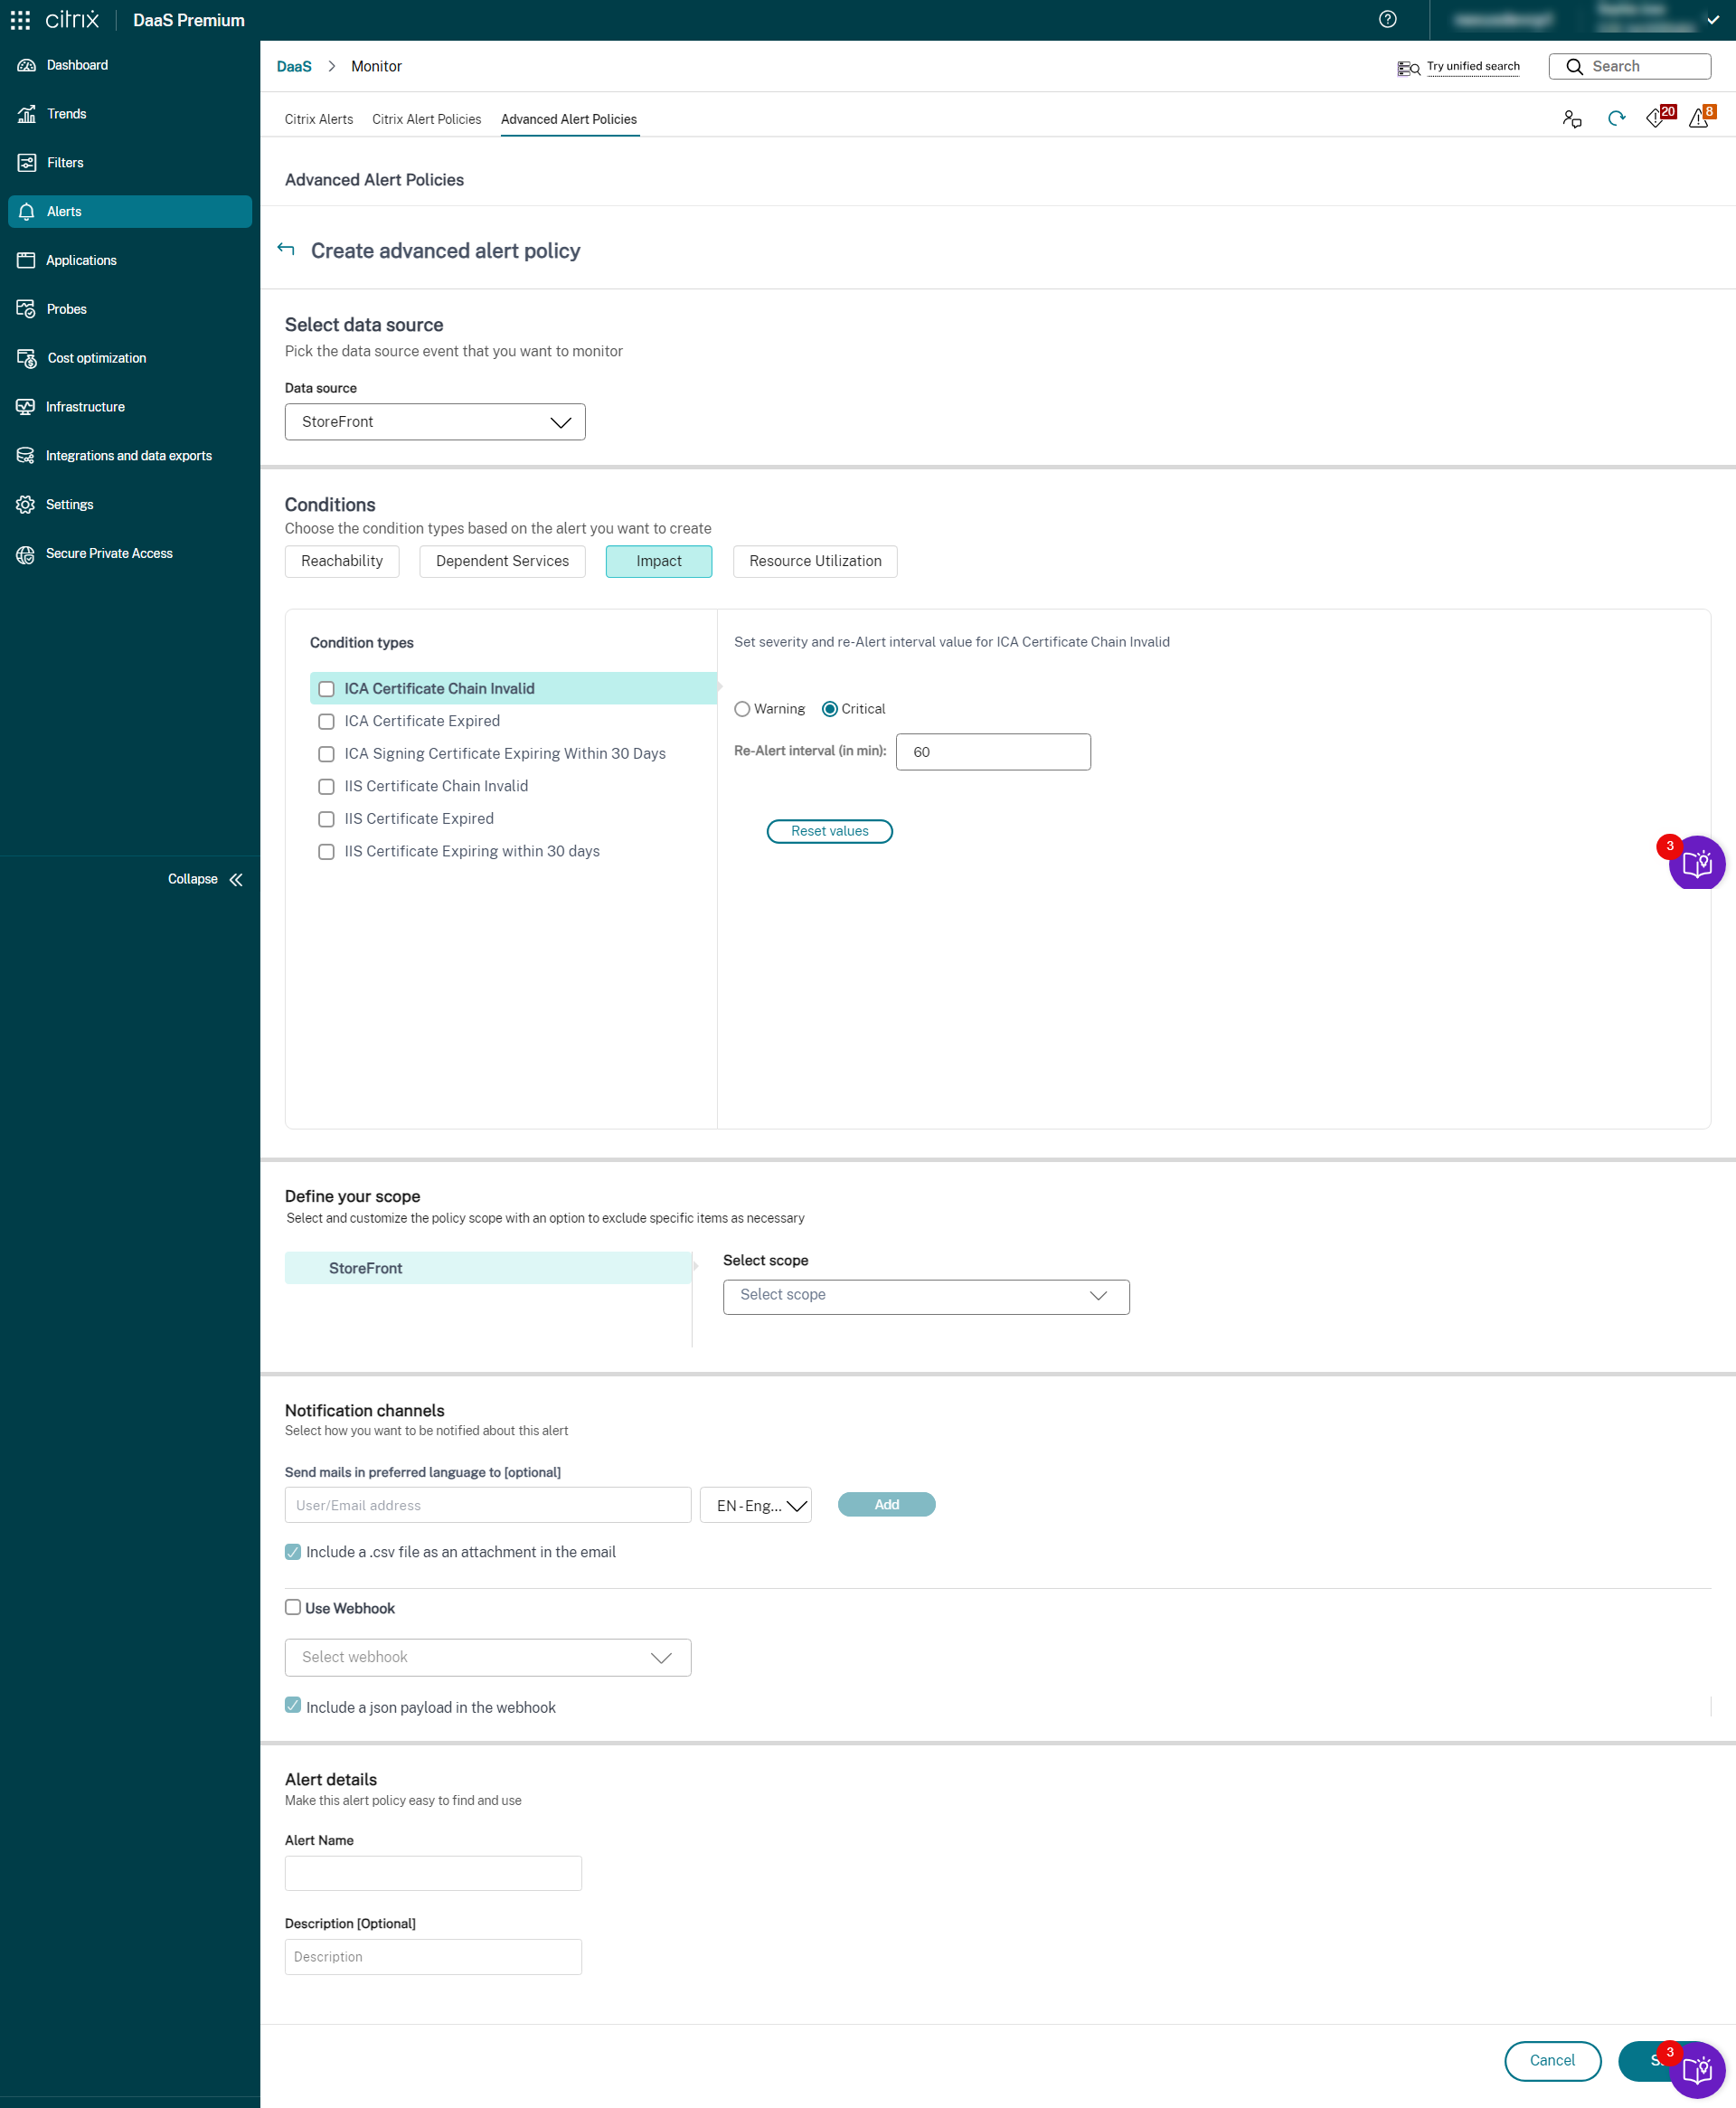
-
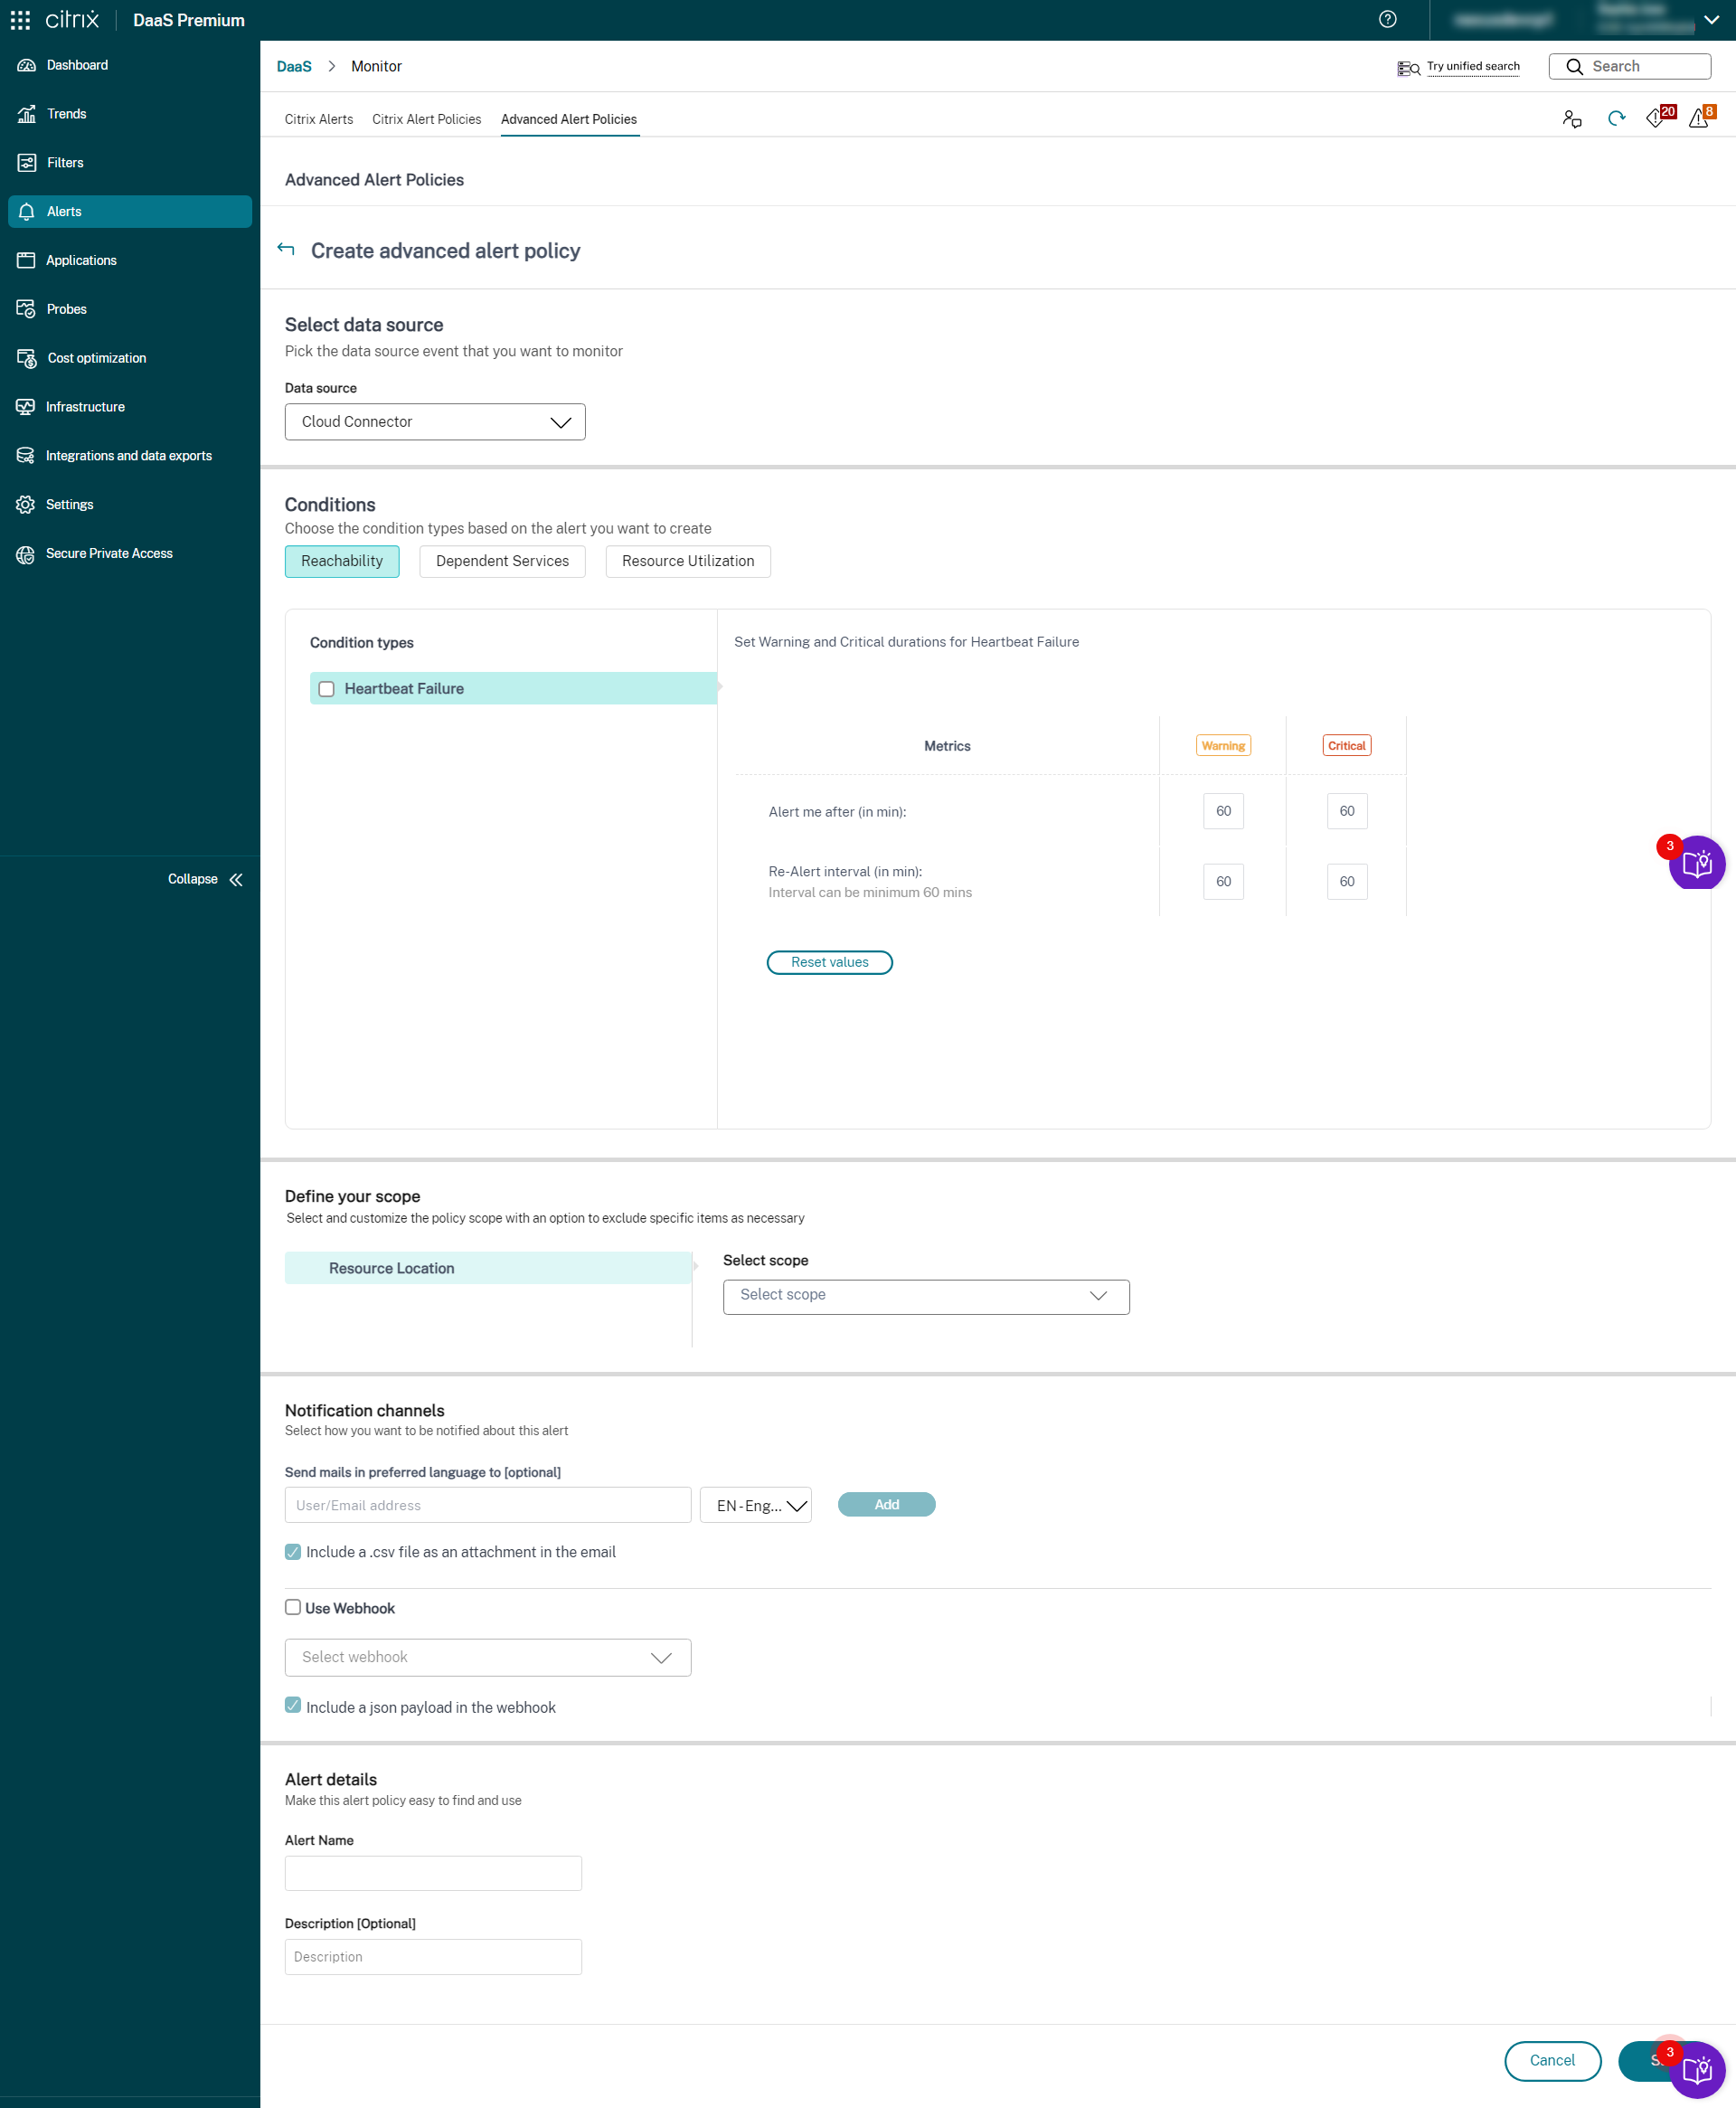
Cloud Connector
-
Connector Appliance
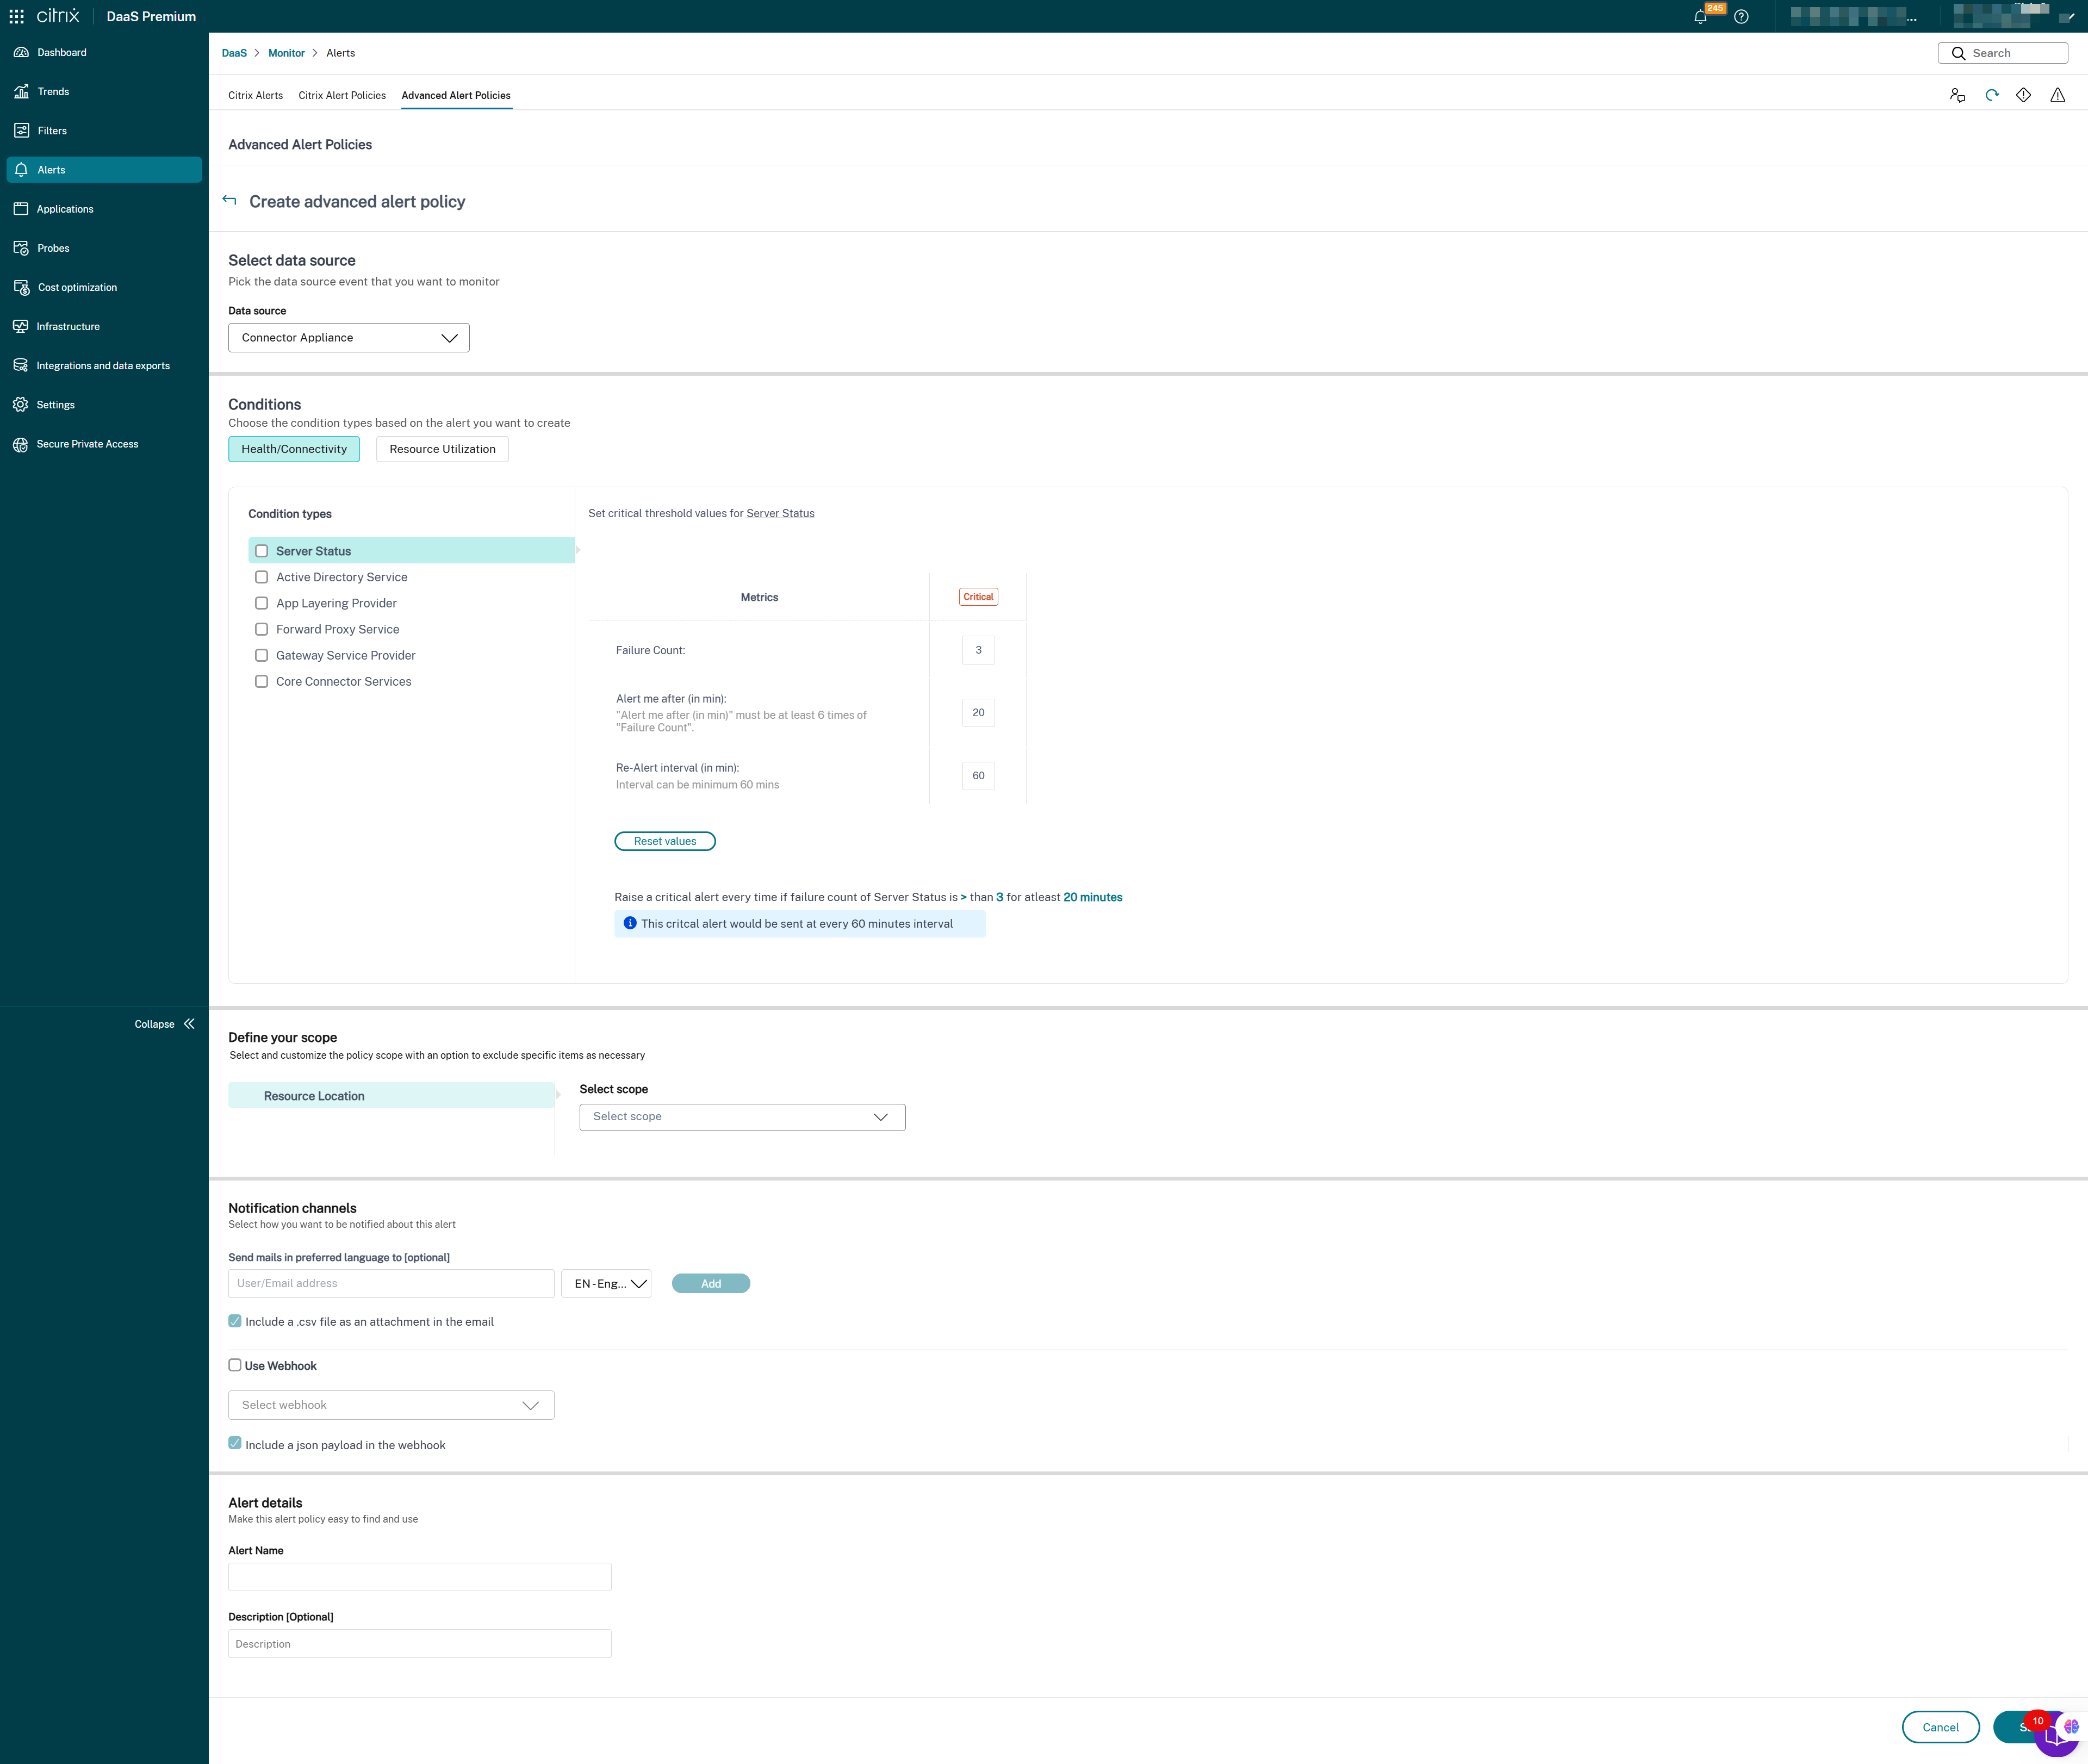
Uma vez que a configuração do monitoramento de infraestrutura esteja concluída, você pode usar os dados de saúde disponíveis no Monitor para configurar alertas para qualquer componente necessário. Os administradores podem definir condições, escopos e meios de notificação para receber alertas importantes por e-mail ou um payload JSON por meio de webhooks. Os alertas gerados também estão disponíveis na seção Alertas Citrix para análise e gerenciamento.
Como parte da política de infraestrutura recém-introduzida, as condições de alerta são categorizadas em quatro seções, conforme a seguir:
-
Acessibilidade
-
Serviços dependentes
-
Impacto
-
Utilização de recursos
As condições dentro de cada categoria podem ser definidas com a severidade de Crítico e Aviso com base nas prioridades da sua organização. Você também pode agendar intervalos de re-alerta para esses alertas.
Você pode criar uma política de infraestrutura na seção Alertas > Políticas de Alerta Citrix. Você pode selecionar a categoria necessária e, em seguida, selecionar as condições necessárias para a política. Para obter mais informações sobre como criar uma política, consulte Criar políticas de alerta. Depois que a política é criada, você pode editar, excluir ou desabilitar a política na página Alertas Citrix.
Para obter mais detalhes sobre as condições suportadas em cada categoria e componente, consulte o seguinte:
Os seguintes dados são recebidos como um alerta por e-mail ou na página de Alertas Citrix:
| Campo | Descrição |
|---|---|
| ID do Cliente | O ID do cliente do site. |
| Nível de alerta | Os valores possíveis são Crítico e Aviso. |
| Alvo | O nome da máquina para a qual o alerta é acionado. |
| Hora | A hora em que o alerta é acionado. |
| Escopo | O escopo da política. |
| Política | O nome da política. |
| Descrição | A descrição do problema para o qual o alerta é acionado. |
Definir o escopo da política
Você pode definir o escopo do seu alerta e adicionar exceções. O alerta é gerado apenas para o escopo selecionado e o subescopo excluído usando adicionar exceções não é incluído na geração do alerta. Este recurso ajuda você a criar alertas em um nível granular.
Você pode criar notificações por e-mail ou por URLs de webhook. Você também pode selecionar seu idioma preferido no qual gostaria de receber alertas. Você também pode selecionar uma opção para receber os parâmetros do alerta em um anexo de arquivo .CSV para e-mail ou em um payload JSON por meio de uma URL de webhook. O anexo inclui detalhes dos parâmetros necessários. Para obter mais informações, consulte Aprimoramentos no conteúdo do alerta.
Os seguintes dados são recebidos como um alerta por e-mail ou na página Citrix Alerts:
| Campo | Descrição |
|---|---|
| ID do Cliente | O ID do cliente do site. |
| Nível do alerta | Este valor é o valor predefinido para cada condição de alerta. Os valores possíveis são Crítico e Aviso. |
| Condição | Este valor é a condição definida ao criar a política. Por exemplo, o número de máquinas não registradas é igual ou superior a 20. |
| Alvo | O nome do grupo de entrega ou site para o qual o alerta é acionado. |
| Site | O nome do site. |
| Escopo | O escopo da política. Este valor também inclui o subescopo. |
| Política | O nome da política. |
| Descrição | A descrição do problema para o qual o alerta é acionado. |
Como criar uma política de alerta avançada usando um script PowerShell?
Script PowerShell para criar uma política de alerta:
asnp Citrix.Monitor.*
 # Add Parameters
 $timeSpan = New-TimeSpan -Seconds 30
 $alertThreshold = 1
 $alarmThreshold = 2
 # Add Target UID's
 $targetIds = @()
 $targetIds += "e9a211b4-a1f3-4f74-b6c7-85225902e997"
 # Add email addresses
 $emailaddress = @()
 $emailaddress += "loki@abc.com"
 # Create new policy
 $policy = New-MonitorNotificationPolicy -Name "FailedMachinePercentageAlertCreationViaPowershell" -Description "Policy created to test urm" -Enabled $true
Substitua a seguinte linha pela condição correta para FailedMachinePercentage
Add-MonitorNotificationPolicyCondition -Uid $policy.Uid -ConditionType FailedMachinePercentage -AlertThreshold $alertThreshold -AlarmThreshold $alarmThreshold -AlertRenotification $timeSpan -AlarmRenotification $timeSpan

 Add-MonitorNotificationPolicyTargets -Uid $policy.Uid -Scope "DG-Multisession" -TargetKind DesktopGroup -TargetIds $targetIds

 $policy = Get-MonitorNotificationPolicy -Uid $policy.Uid
 $policy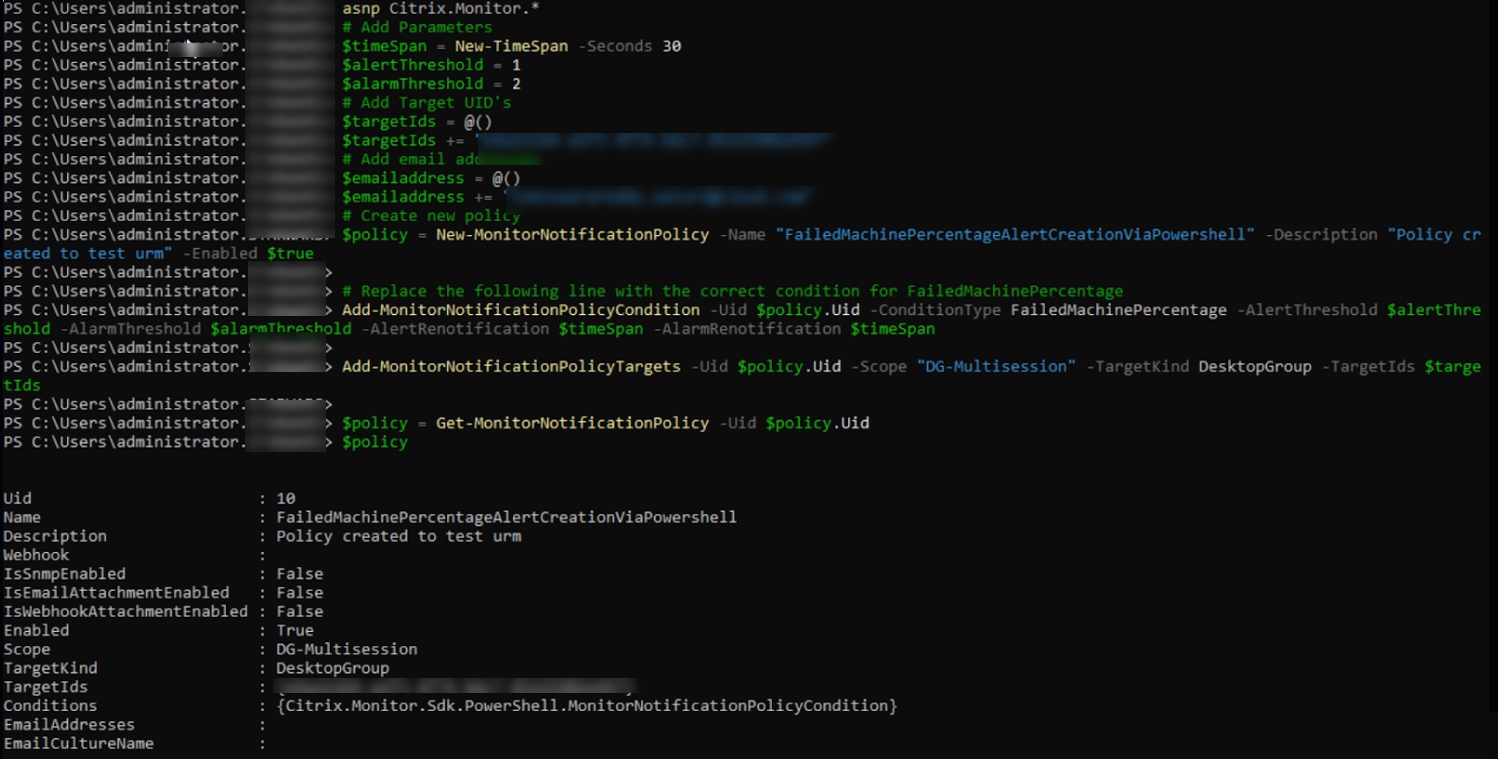
Na imagem anterior, você pode ver que a política foi criada e o Uid é 10.
Para adicionar e-mail à configuração
Set-MonitorNotificationEmailServerConfiguration -ProtocolType SMTP -ServerName NameOfTheSMTPServerOrIPAddress -PortNumber 80 -SenderEmailAddress loki@abc.com -RequiresAuthentication 0
Para adicionar e-mail à política
Add-MonitorNotificationPolicyEmailAddresses -Uid $policy.Uid -EmailAddresses $emailaddress -EmailCultureName "en-US"
Script de exemplo para adicionar e-mail:
Add-MonitorNotificationPolicyEmailAddresses -Uid 10 -EmailAddresses $emailaddress -EmailCultureName "en-US"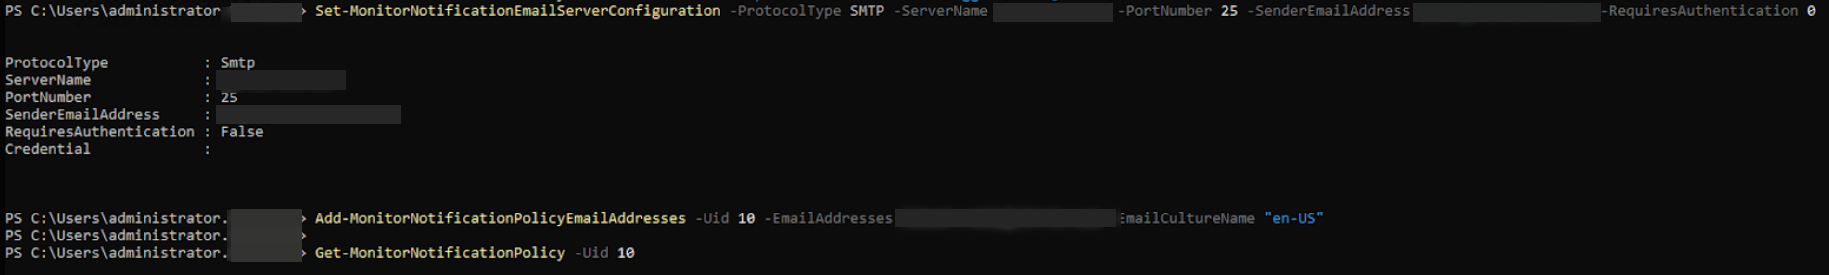
Para adicionar URL de Webhook à política
Set-MonitorNotificationPolicy –Uid $polcy.Uid –Webhook 'URL'
Script de exemplo para adicionar URL de webhook:
Set-MonitorNotificationPolicy –Uid 10 –Webhook 'https://hooks.slack.com/triggers/<TeamId>/<WorkflowId>/<Token>'
Obter detalhes da política criada
Get-MonitorNotificationPolicy -Uid 10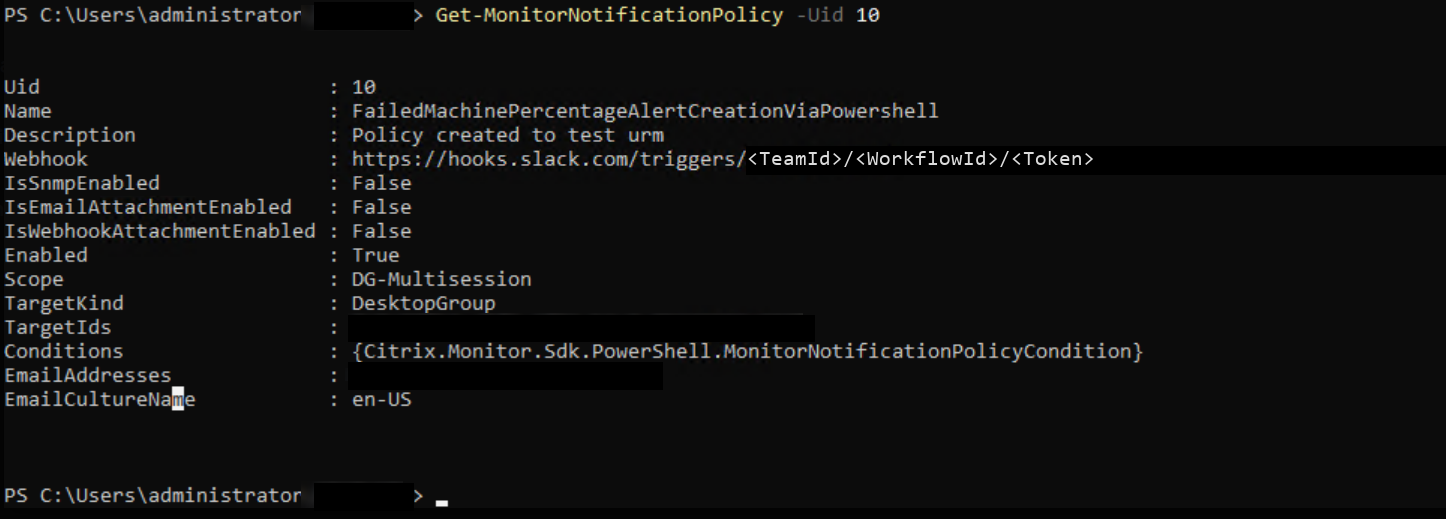
Criar políticas de alerta
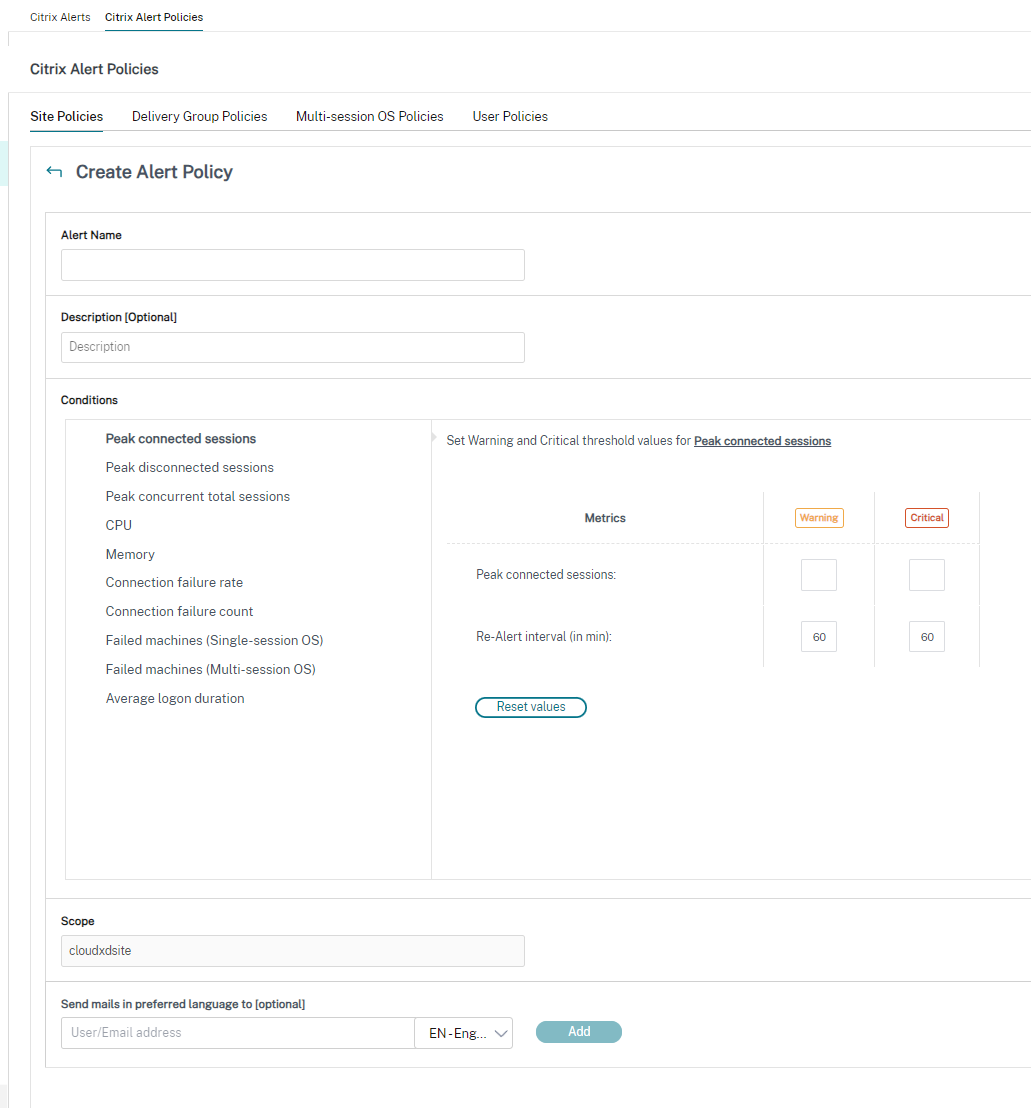
Para criar uma política de alerta, por exemplo, para gerar um alerta quando um conjunto específico de critérios de contagem de sessões for atendido:
-
Vá para Alertas \> Política de Alertas do Citrix e selecione, por exemplo, Política de SO de Múltiplas Sessões.
-
Clique em Criar.
-
Nomeie e descreva a política, depois defina as condições que devem ser atendidas para que o alerta seja acionado. Por exemplo, especifique as contagens de Aviso e Crítico para Sessões Conectadas de Pico, Sessões Desconectadas de Pico e Sessões Totais Concorrentes de Pico. Os valores de Aviso não devem ser maiores que os valores Críticos. Para obter mais informações, consulte Condições das políticas de alerta.
-
Defina o intervalo de Re-alerta. Se as condições para o alerta ainda forem atendidas, o alerta será acionado novamente neste intervalo de tempo e, se configurado na política de alerta, uma notificação por e-mail será gerada. Um alerta ignorado não gera uma notificação por e-mail no intervalo de re-alerta.
-
Defina o Escopo. Por exemplo, defina para um grupo de entrega específico.
-
Nas preferências de Notificação, especifique quem deve ser notificado por e-mail quando o alerta for acionado. As notificações por e-mail são enviadas via SendGrid. Certifique-se de que o endereço de e-mail
donotreplynotifications@citrix.comesteja na lista de permissões da sua configuração de e-mail. -
Clique em Salvar.
A criação de uma política com 20 ou mais grupos de entrega definidos no Escopo pode levar aproximadamente 30 segundos para concluir a configuração. Um spinner é exibido durante esse tempo.
A criação de mais de 50 políticas para até 20 grupos de entrega exclusivos (1000 destinos de grupo de entrega no total) pode resultar em um aumento no tempo de resposta (mais de 5 segundos).
Mover uma máquina contendo sessões ativas de um grupo de entrega para outro pode acionar alertas de grupo de entrega errôneos que são definidos usando parâmetros de máquina.
Nota:
Depois de excluir uma política de alerta, pode levar até 30 minutos para que as notificações de alerta geradas pela política parem.
Aprimoramentos no conteúdo do alerta
O recurso de alerta do Monitor foi aprimorado para incluir um anexo CSV e um payload JSON. Com esse aprimoramento, você pode obter detalhes do alerta em um anexo CSV por e-mail ou como um payload JSON se houver um webhook. Usando este anexo CSV ou payload JSON, você pode receber conteúdo enriquecido em um nível detalhado, auxiliando na rápida identificação e resolução de problemas.
Atualmente, esse aprimoramento está disponível apenas nos seguintes alertas:
-
Tempo de atividade da máquina
-
Ações de inicialização com falha
-
Ações de desligamento com falha
-
Máquinas não registradas (%)
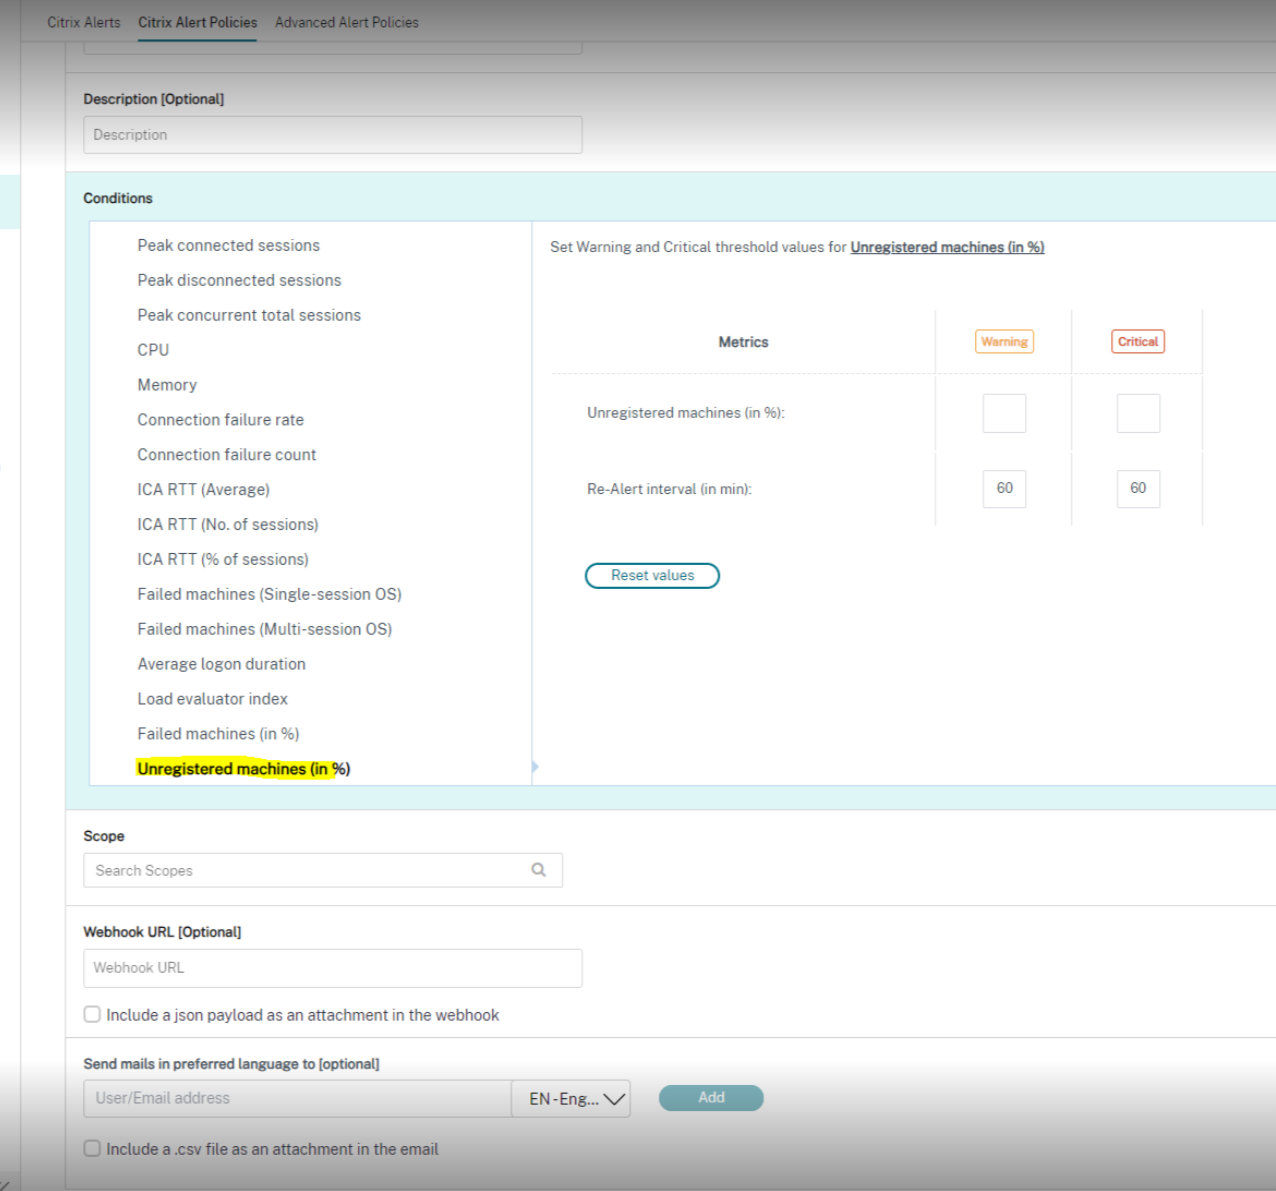
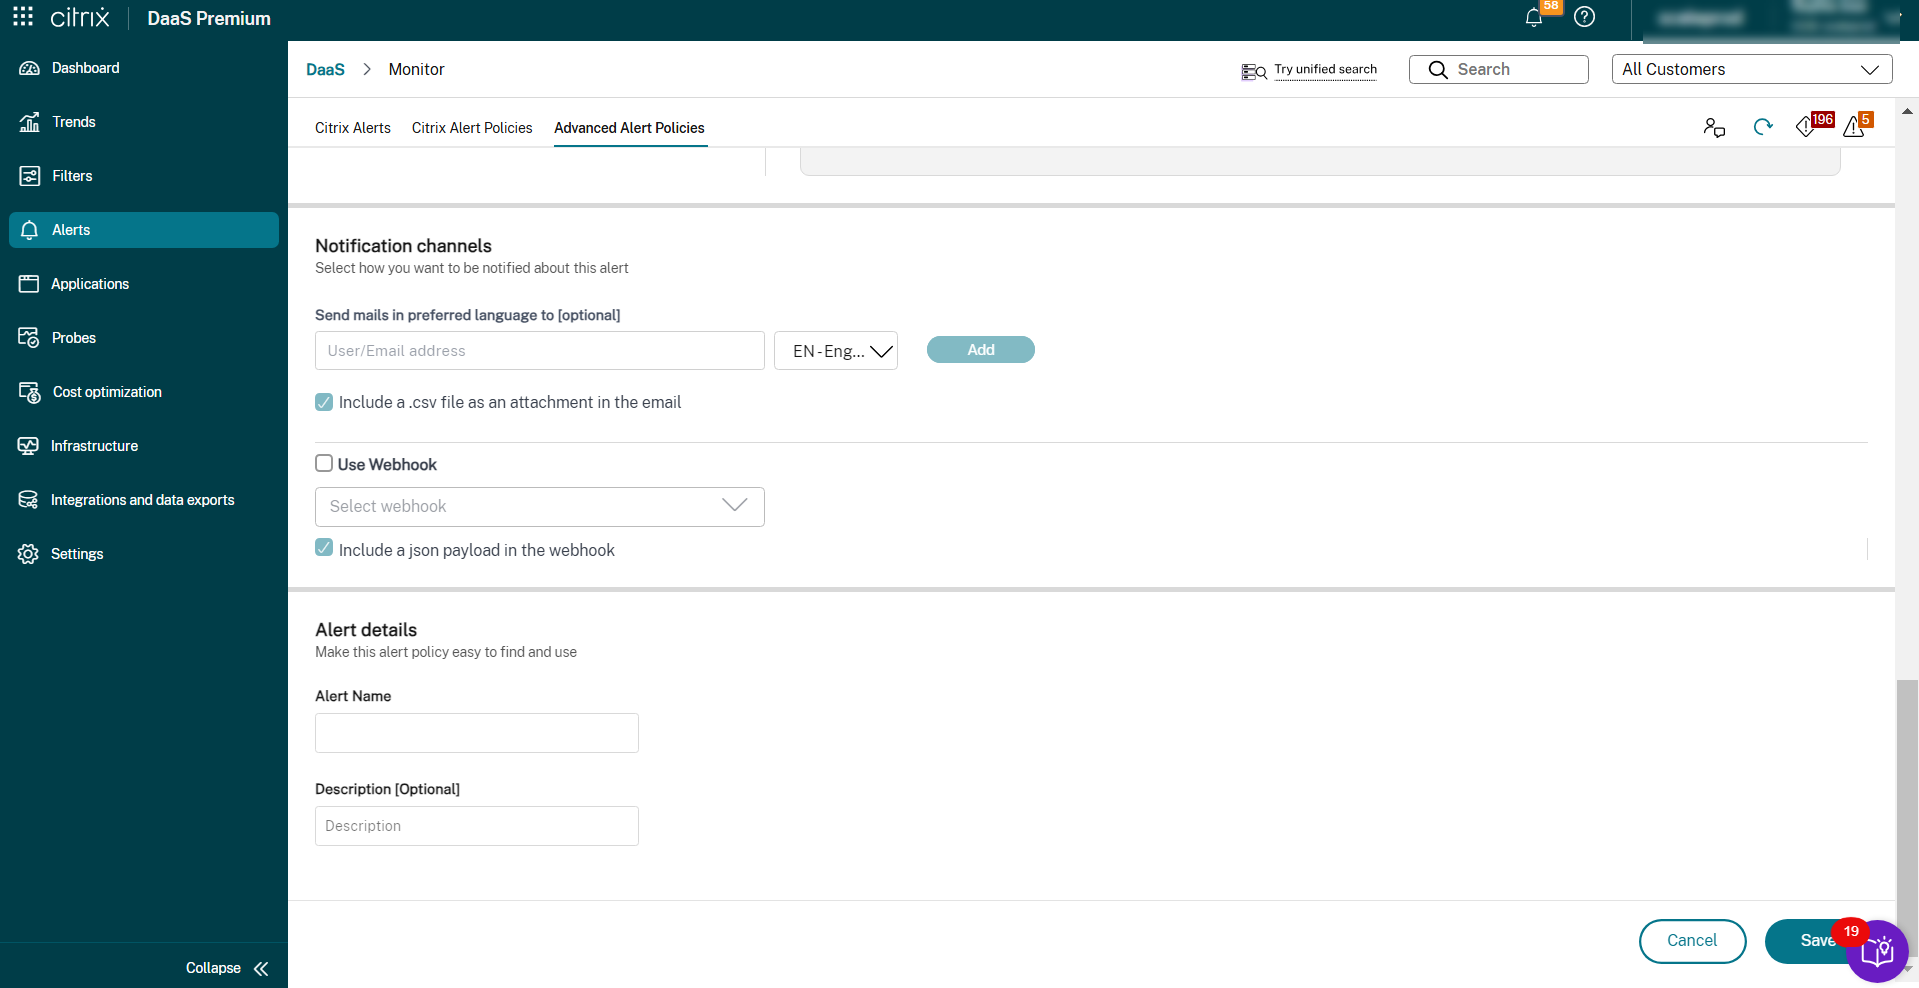
Para usar este recurso, navegar até o alerta e selecione as seguintes caixas de seleção:
-
Incluir um payload JSON como anexo no webhook
-
Incluir um arquivo CSV como anexo no e-mail
A seguir, uma captura de tela da seção Políticas de Alerta do Citrix:
Aqui está uma captura de tela da seção Políticas de Alerta Avançadas:
Anexo CSV
A tabela a seguir fornece as colunas do anexo .CSV para todos os alertas suportados:
| Coluna | Alerta aplicável |
|---|---|
| Nome da Máquina, Endereço IP e Nome do Grupo de Entrega | Tempo de atividade da máquina, Ação de desligamento falha e Ação de ligamento falha, e Máquinas não registradas (%) |
| Estado de Registro Atual, Data da Falha, Estado de Falha e Estado do Ciclo de Vida | Máquina não registrada (%) |
| Motivo da Falha da Última Ação de Energia, Última Ação de Energia Acionada Por, Tipo da Última Ação de Energia e Data de Conclusão da Última Ação de Energia | Ação de desligamento falha e Ação de inicialização falha |
| Estado de Energia, Data de Inicialização e Tempo Total de Atividade em Minutos | Tempo de atividade da máquina |
Payload do webhook
Alerta de Porcentagem de Máquinas Não Registradas
{
   "text": "{\"Address\":\"<Webhook URL>\",\"NotificationId\":\"<NotificationGUID>\",\"NotificationState\":\"NotificationActive\",\"Priority\":\"<Critical/Warning>\",\"Target\":\"<DeliveryGroupName>\",\"Condition\":\"Unregistered machines (in %)\",\"Value\":\"<Value Set as Threshold>\",\"Timestamp\":\"<Timestamp string Eg: April 25, 2024 9:33 PM (UTC +5)>\",\"PolicyName\":\"<Alert Policy Name>\",\"Description\":\"<Alert Policy Description>\",\"Scope\":\"DeliveryGroup\",\"Site\":\"<Name of the Site>\",\"AttachmentData\":[{\"MachineName\":\"<Name of the Machine>\",\"IPAddress\":\"<IP Address>\",\"DeliveryGroupName\":\"<Name of the DeliveryGroup>\",\"CurrentRegistrationState\":\"Unregistered\",\"FailureDate\":\"<Date of Failure>\",\"FaultState\":\"<Fault State of the Machine>\",\"LifecycleState\":\"<Lifecycle state of the Machine>\"},{\"MachineName\":\"<Name of the Machine>\",\"IPAddress\":\"<IP Address>\",\"DeliveryGroupName\":\"<Name of the DeliveryGroup>\",\"CurrentRegistrationState\":\"Unregistered\",\"FailureDate\":\"<Date of Failure>\",\"FaultState\":\"<Fault State of the Machine>\",\"LifecycleState\":\"<Lifecycle state of the Machine>\"}]}"
 }
Alerta de ações de inicialização falhas
{
   "text": "{\"Address\":\"<Webhook URL>\",\"NotificationId\":\"<NotificationGUID>\",\"NotificationState\":\"NotificationActive\",\"Priority\":\"<Critical/Warning>\",\"Target\":\"<DeliveryGroupName>\",\"Condition\":\"Failure To PowerOn Action\",\"Value\":\"<Value Set as Threshold>\",\"Timestamp\":\"<Timestamp string Eg: April 25, 2024 9:33 PM (UTC +5)>\",\"PolicyName\":\"<Alert Policy Name>\",\"Description\":\"<Alert Policy Description>\",\"Scope\":\"DeliveryGroup\",\"Site\":\"<Name of the Site>\",\"AttachmentData\":[{\"MachineName\":\"<Name of the Machine>\",\"IPAddress\":\"<IP Address>\",\"DeliveryGroupName\":\"<Name of the DeliveryGroup>\",\"LastPowerActionFailureReason\":\"<HypervisorReportedFailure, HypervisorRateLimitExceeded, UnknownError, Power Action Type>\",\"LastPowerActionTriggeredBy\":\"<End-User, Administrator, Auto-Scale, Schedule>\",\"LastPowerActionType\":\"<PowerOn/PowerOff>\",\"LastPowerActionCompletedDate\":\"<Time string Eg: 2024-05-15T15:04:27.723>\"},{\"MachineName\":\"<Name of the Machine>\",\"IPAddress\":\"<IP Address>\",\"DeliveryGroupName\":\"<Name of the DeliveryGroup>\",\"LastPowerActionFailureReason\":\"<HypervisorReportedFailure, HypervisorRateLimitExceeded, UnknownError, Power Action Type>\",\"LastPowerActionTriggeredBy\":\"<End-User, Administrator, Auto-Scale, Schedule>\",\"LastPowerActionType\":\"<PowerOn/PowerOff>\",\"LastPowerActionCompletedDate\":\"<Time string Eg: 2024-05-15T15:04:27.723>\"}]}"
 }
Alerta de ações de desligamento falhas
{
   "text": "{\"Address\":\"<Webhook URL>\",\"NotificationId\":\"<NotificationGUID>\",\"NotificationState\":\"NotificationActive\",\"Priority\":\"<Critical/Warning>\",\"Target\":\"<DeliveryGroupName>\",\"Condition\":\"Failure To PowerOff Action\",\"Value\":\"<Value Set as Threshold>\",\"Timestamp\":\"<Timestamp string Eg: April 25, 2024 9:33 PM (UTC +5)>\",\"PolicyName\":\"<Alert Policy Name>\",\"Description\":\"<Alert Policy Description>\",\"Scope\":\"DeliveryGroup\",\"Site\":\"<Name of the Site>\",\"AttachmentData\":[{\"MachineName\":\"<Name of the Machine>\",\"IPAddress\":\"<IPV4 Address of the Machine>\",\"DeliveryGroupName\":\"<Name of the DeliveryGroup>\",\"LastPowerActionFailureReason\":\"<HypervisorReportedFailure,HypervisorRateLimitExceeded,UnknownError,Power Action Type>\",\"LastPowerActionTriggeredBy\":\"<End-User,Administrator,Auto-Scale,Schedule>\",\"LastPowerActionType\":\"<PowerOn/PowerOff>\",\"LastPowerActionCompletedDate\":\"<Time string Eg: 2024-05-15T15:04:27.723>\"},{\"MachineName\":\"<Name of the Machine>\",\"IPAddress\":\"<IPV4 Address of the Machine>\",\"DeliveryGroupName\":\"<Name of the DeliveryGroup>\",\"LastPowerActionFailureReason\":\"<HypervisorReportedFailure,HypervisorRateLimitExceeded,UnknownError,Power Action Type>\",\"LastPowerActionTriggeredBy\":\"<End-User,Administrator,Auto-Scale,Schedule>\",\"LastPowerActionType\":\"<PowerOn/PowerOff>\",\"LastPowerActionCompletedDate\":\"<Time string Eg: 2024-05-15T15:04:27.723>\"}]}"
 }
Alerta de tempo de atividade da máquina
{
   "text": "{\"Address\":\"<Webhook URL>\",\"NotificationId\":\"<NotificationGUID>\",\"NotificationState\":\"NotificationActive\",\"Priority\":\"<Critical/Warning>\",\"Target\":\"<DeliveryGroupName>\",\"Condition\":\"Machine Uptime Alert\",\"Value\":\"<Value Set as Threshold>\",\"Timestamp\":\"<Timestamp string Eg: April 25, 2024 9:33 PM (UTC +5)>\",\"PolicyName\":\"<Alert Policy Name>\",\"Description\":\"<Alert Policy Description>\",\"Scope\":\"DeliveryGroup\",\"Site\":\"<Name of the Site>\",\"AttachmentData\":[{\"MachineName\":\"<Name of the Machine>\",\"IPAddress\":\"<IP Address>\",\"DeliveryGroupName\":\"<Name of the DeliveryGroup>\",\"PowerState\":\"<On/Off>\",\"PoweredOnDate\":\"2024-05-15T15:04:27.723\",\"TotalUptimeInMinutes\":180},{\"MachineName\":\"<Name of the Machine>\",\"IPAddress\":\"<IP Address>\",\"DeliveryGroupName\":\"<Name of the DeliveryGroup>\",\"PowerState\":\"<ON/OFF>\",\"PoweredOnDate\":\"2024-05-15T15:04:27.723\",\"TotalUptimeInMinutes\":\"<Uptime Duration>\"}]}"
 }
Condições das políticas de alertas
Encontre abaixo as categorias de alerta, as ações recomendadas para mitigar o alerta e as condições de política integradas, se definidas. As políticas de alerta integradas são definidas para intervalos de alerta e realerta de 60 minutos.
Pico de Sessões Conectadas
-
Verifique a exibição Tendências de Sessão do Monitor para picos de sessões conectadas.
-
Verifique se há capacidade suficiente para acomodar a carga da sessão.
-
Adicione novas máquinas, se necessário
Pico de Sessões Desconectadas
-
Verifique a visualização Tendências de Sessão do Monitor para sessões desconectadas de pico.
-
Verifique se há capacidade suficiente para acomodar a carga da sessão.
-
Adicione novas máquinas, se necessário.
-
Faça logoff das sessões desconectadas, se necessário.
Pico de Sessões Totais Concorrentes
-
Verifique a visualização Tendências de Sessão do Monitor em Monitor para sessões concorrentes de pico.
-
Verifique se há capacidade suficiente para acomodar a carga da sessão.
-
Adicione novas máquinas, se necessário.
-
Faça logoff das sessões desconectadas, se necessário.
CPU
A porcentagem de uso da CPU indica o consumo geral da CPU no VDA, incluindo o dos processos. Você pode obter mais informações sobre a utilização da CPU por processos individuais na página Detalhes da máquina do VDA correspondente.
-
Vá para Detalhes da Máquina > Exibir Utilização Histórica > 10 Principais Processos, identifique os processos que consomem a CPU. Certifique-se de que a política de monitoramento de processos esteja habilitada para iniciar a coleta de estatísticas de uso de recursos em nível de processo.
-
Encerre o processo, se necessário.
-
Encerrar o processo faz com que os dados não salvos sejam perdidos.
-
Se tudo estiver funcionando como esperado, adicione mais recursos de CPU no futuro.Nota:A configuração de política, Habilitar monitoramento de recursos, é permitida por padrão para o monitoramento de contadores de desempenho de CPU e memória em máquinas com VDAs. Se esta configuração de política estiver desabilitada, alertas com condições de CPU e memória não são acionados. Para obter mais informações, consulte Configurações de política de monitoramento.Condições de política inteligente:
-
Escopo: Grupo de entrega, escopo de SO multi-sessão
-
Valores de limite: Aviso - 80%, Crítico - 90%
-
Memória
A porcentagem de uso da memória indica o consumo geral de memória no VDA, incluindo o dos processos. Você pode obter mais informações sobre o uso da memória por processos individuais na página Detalhes da máquina do VDA correspondente.
-
Vá para Detalhes da Máquina > Exibir Utilização Histórica > 10 Principais Processos, identifique os processos que consomem memória. Certifique-se de que a política de monitoramento de processos esteja habilitada para iniciar a coleta de estatísticas de uso de recursos em nível de processo.
-
Encerre o processo, se necessário.
-
Encerrar o processo causa a perda de dados não salvos.
-
Se tudo estiver funcionando como esperado, adicione mais memória no futuro.Nota:A configuração de política Habilitar monitoramento de recursos é permitida por padrão para o monitoramento de contadores de desempenho de CPU e memória em máquinas com VDAs. Se esta configuração de política estiver desabilitada, alertas com condições de CPU e memória não são acionados. Para obter mais informações, consulte Configurações de política de monitoramento.Condições de política inteligente:
-
Escopo: Grupo de entrega, escopo de SO multi-sessão
-
Valores de limite: Aviso - 80%, Crítico - 90%
-
Taxa de Falha de Conexão
Porcentagem de falhas de conexão na última hora.
-
Calculado com base no total de falhas em relação ao total de conexões tentadas.
-
Verifique a visualização Tendências de Falhas de Conexão do Monitor para eventos registrados no log de Configuração.
-
Determine se aplicativos ou desktops estão acessíveis.
Contagem de Falhas de Conexão
Número de falhas de conexão na última hora.
-
Verifique a visualização Tendências de Falhas de Conexão do Monitor para eventos registrados no log de Configuração.
-
Determine se aplicativos ou desktops estão acessíveis.
ICA® RTT (Média)
Tempo médio de ida e volta do ICA.
-
Verifique o Citrix ADM para uma análise detalhada do RTT do ICA para determinar a causa raiz. Para obter mais informações, consulte a documentação do Citrix ADM.
-
Se o Citrix ADM não estiver disponível, verifique a visualização Detalhes do Usuário do Monitor para o RTT do ICA e a Latência, e determine se é um problema de rede ou um problema com aplicativos ou desktops.
ICA RTT (Nº de Sessões)
Número de sessões que excedem o tempo de ida e volta ICA limite.
-
Verifique o Citrix ADM para o número de sessões com alto RTT ICA. Para mais informações, consulte a documentação do Citrix ADM.
-
Se o Citrix ADM não estiver disponível, entre em contato com a equipe de rede para determinar a causa raiz.Condições da política inteligente:
-
Escopo: Grupo de entrega, escopo de SO multissessão
-
Valores limite: Aviso - 300 ms para 5 ou mais sessões, Crítico - 400 ms para 10 ou mais sessões
-
RTT ICA (% de Sessões)
Porcentagem de sessões que excedem o tempo médio de ida e volta ICA.
-
Verifique o Citrix ADM para o número de sessões com alto RTT ICA. Para mais informações, consulte a documentação do Citrix ADM.
-
Se o Citrix ADM não estiver disponível, entre em contato com a equipe de rede para determinar a causa raiz.
RTT ICA (Usuário)
Tempo de ida e volta ICA que é aplicado às sessões iniciadas pelo usuário especificado. O alerta é acionado se o RTT ICA for maior que o limite em pelo menos uma sessão.
Máquinas com falha (SO de sessão única)
Número de máquinas de SO de sessão única com falha. As falhas podem ocorrer por várias razões, conforme mostrado nos painéis Monitor e Filtros.
-
Execute os diagnósticos do Citrix Scout para determinar a causa raiz. Para mais informações, consulte Solucionar problemas do usuário.Condições de política inteligente:
-
Escopo: Escopo do grupo de entrega
-
Valores de limite: Aviso - 1, Crítico - 2
-
Máquinas com falha (SO multiusuário)
Número de máquinas de SO multiusuário com falha. As falhas podem ocorrer por vários motivos, conforme mostrado nas visualizações do Painel de Monitoramento e Filtros.
-
Execute os diagnósticos do Citrix Scout para determinar a causa raiz.Condições de política inteligente:
-
Escopo: Grupo de entrega, escopo de SO multiusuário
-
Valores de limite: Aviso - 1, Crítico - 2
-
Máquinas com falha (em %)
A porcentagem de máquinas de SO de sessão única e multiusuário com falha em um grupo de entrega, calculada com base no número de máquinas com falha. Essa condição de alerta permite configurar limites de alerta como uma porcentagem de máquinas com falha em um grupo de entrega e é calculada a cada 30 segundos. As falhas podem ocorrer por vários motivos, conforme mostrado nas visualizações do Painel de Monitoramento e Filtros. Execute os diagnósticos do Citrix Scout para determinar a causa raiz. Para obter mais informações, consulte Solucionar problemas do usuário.
Ação de ligar com falha e ação de desligar com falha
Número de ações de ligar com falha e número de ações de desligar com falha em um grupo de entrega, calculados com base no número de Máquinas Gerenciadas por Energia que falharam ao ligar ou desligar. Essa condição de alerta permite configurar limites de alerta como o número de Máquinas Gerenciadas por Energia que falharam ao ligar ou desligar em um grupo de entrega e é calculada a cada 30 minutos.
O administrador pode configurar os seguintes parâmetros para esses alertas na política de alerta avançada:
-
Acionado por: O que acionou a ação de energia
-
Motivo da falha: Por que a ação falhou
-
Limite: Número limite de máquinas que falharam na ação de energia para acionar a política
-
Intervalo de amostragem: O intervalo em que a ação de energia com falha deve ser verificada
-
Intervalo de reenvio de alerta: Após quanto tempo o alerta deve ser reenviado
Falhas podem ocorrer por vários motivos, conforme mostrado nas exibições do Painel do Monitor e Filtros. Execute os diagnósticos do Citrix Scout para determinar a causa raiz. Para obter mais informações, consulte Solucionar problemas do usuário.
Máquinas não registradas (em %)
Uma máquina é considerada não registrada quando se torna instável devido a uma reinicialização ou quando há um problema de comunicação entre o delivery controller™ e as máquinas virtuais. A Máquinas não registradas (em %) é a porcentagem de máquinas OS de sessão única e multissessão não registradas em um grupo de entrega, calculada com base no número de máquinas não registradas. Esta condição de alerta permite configurar valores de limite de aviso e críticos como uma porcentagem de máquinas não registradas em um grupo de entrega. Você pode definir um intervalo para o reenvio do alerta. Você também pode adicionar um e-mail para receber uma notificação quando as condições forem atendidas para Máquinas não registradas (em %). Quando o valor limite crítico ou de aviso é excedido, alertas e e-mails são gerados. Você pode visualizar alertas em Alertas do Citrix. Você pode filtrá-lo pela categoria Máquinas não registradas (em %) e para o estado e tempo necessários.
Nota:
O valor crítico deve ser maior que o valor de aviso.
Condições da política:
-
Escopo: OS de sessão única e grupo de entrega de OS multissessão
-
Valores limite: Aviso e Crítico
Alerta de tempo de atividade da máquina
O tempo de atividade da máquina em um grupo de entrega é calculado com base no número de horas por dia, horas por semana ou horas por mês para uma máquina que está ligada em um grupo de entrega. Esta condição de alerta permite configurar limites de alerta como as horas em que uma máquina está ligada em um grupo de entrega. Os alertas de tempo de atividade da máquina funcionam da seguinte forma no caso de:
-
Horas por dia - Você pode especificar o número de horas em que uma máquina fica ligada por dia e é calculado a cada 30 minutos. O número máximo de horas por dia que você pode definir é de 24 horas.
-
Horas por semana - Você pode especificar o número de horas que uma máquina fica ligada por semana e é calculado a cada seis horas. O número máximo de horas por semana que você pode definir é de 168 horas.
-
Horas por mês - Você pode especificar o número de horas que uma máquina fica ligada por mês e é calculado uma vez por dia. O número máximo de horas por mês é de 720 horas. O valor mínimo do intervalo de re-alerta que você pode definir é de 60 minutos. Você pode inserir o número de máquinas que excedem o valor limite de tempo de atividade da máquina na seção de alertas de Aviso e Crítico. Você também pode adicionar exceções para quaisquer máquinas.
Por exemplo, se houver cinco grupos de entrega adicionados para este alerta e se no primeiro grupo de entrega e no quarto grupo de entrega, o número de máquinas exceder os valores limite de aviso ou crítico, o alerta será acionado separadamente para o primeiro grupo de entrega e para o quarto grupo de entrega.
Este alerta ajuda os administradores a analisar o tempo de atividade das máquinas e, com base nessa análise, os administradores podem ajudar a otimizar o custo. Você também pode receber detalhes do alerta em um anexo CSV em um e-mail ou por meio de um payload JSON no caso de um webhook.
Duração Média do Logon
Duração média do logon para logons que ocorreram na última hora.
-
Verifique o Painel do Monitor para obter métricas atualizadas sobre a duração do logon. Um grande número de usuários fazendo logon em um curto período de tempo pode aumentar a duração do logon.
-
Verifique a linha de base e a análise dos logons para identificar a causa. Para obter mais informações, consulte Diagnosticar problemas de logon do usuário.Condições da política inteligente:
-
Escopo: Grupo de entrega, escopo de SO multi-sessão
-
Valores limite: Aviso - 45 segundos, Crítico - 60 segundos
-
Duração do Logon (Usuário)
Duração do logon para logons do usuário especificado que ocorreram na última hora.
Índice do Avaliador de Carga
Valor do Índice do Avaliador de Carga nos últimos 5 minutos.
-
Verifique o Monitor para Máquinas de SO de Multi-sessão que possam ter uma carga de pico (Carga máxima). Visualize tanto o Painel (falhas) quanto o relatório de Tendências do Índice do Avaliador de Carga.Condições de política inteligente:
-
Escopo: Grupo de entrega, escopo de SO de Multi-sessão
-
Valores de limite: Aviso - 80%, Crítico - 90%
-
Configurar políticas de alerta com webhooks
Além das notificações por e-mail, você pode configurar políticas de alerta com webhooks.
Nota: Este recurso requer a versão 7.11 ou posterior do(s) Delivery Controller(s).
Você pode configurar uma política de alerta com um callback HTTP ou um POST HTTP usando cmdlets do PowerShell. Eles foram estendidos para suportar webhooks.
Para obter informações sobre a criação de um novo fluxo de trabalho do Octoblu e a obtenção do URL de webhook correspondente, consulte o Octoblu Developer Hub.
Para configurar um URL de webhook para uma nova política de alerta ou para uma política existente, use os seguintes cmdlets do PowerShell.
Criar política de alerta com um URL de webhook:
$policy = New-MonitorNotificationPolicy -Name <Policy name> -Description <Policy description> -Enabled $true -Webhook <Webhook URL>
Adicionar um URL de webhook a uma política de alerta existente:
Set-MonitorNotificationPolicy - Uid <Policy id> -Webhook <Webhook URL>
Para obter ajuda sobre os comandos do PowerShell, use a ajuda do PowerShell, por exemplo:
Get-Help <Set-MonitorNotificationPolicy>
As notificações geradas a partir da política de alerta acionam o webhook com uma chamada POST para o URL do webhook. A mensagem POST contém as informações da notificação em formato JSON:
{"NotificationId" : \<Notification Id\>,

 "Target" : \<Notification Target Id\>,

 "Condition" : \<Condition that was violated\>,

 "Value" : \<Threshold value for the Condition\>,

 "Timestamp": \<Time in UTC when notification was generated\>,

 "PolicyName": \<Name of the Alert policy\>,

 "Description": \<Description of the Alert policy\>,

 "Scope" : \<Scope of the Alert policy\>,

 "NotificationState": \<Notification state critical, warning, healthy or dismissed\>,

 "Site" : \<Site name\>}
Configurar políticas de alerta com ServiceNow
Você pode configurar políticas de alerta para enviar notificações diretamente para o ServiceNow (SNOW), permitindo uma integração perfeita com seus fluxos de trabalho de Gerenciamento de Serviços de TI (ITSM). Essa integração permite que os alertas gerados no Citrix Monitor sejam automaticamente encaminhados para o ServiceNow para rastreamento centralizado, escalonamento e resolução de incidentes.
Benefícios da integração com o ServiceNow
-
Gerenciamento unificado de alertas: Crie, atualize e gerencie incidentes do ServiceNow diretamente na interface do Citrix Monitor sem alternar entre os sistemas.
-
Configuração automática de ITSM: O Monitor recupera automaticamente a configuração necessária do ServiceNow, como URLs de webhook, reduzindo a complexidade da configuração manual.
-
Resposta simplificada a incidentes: Os alertas são encaminhados para o ServiceNow para rastreamento e resolução centralizados de incidentes, melhorando a eficiência operacional.
Pré-requisitos
Antes de configurar a integração com o ServiceNow, certifique-se do seguinte:
-
Uma instância do ServiceNow está configurada no serviço ITSM Adapter.
-
Você tem as permissões necessárias para gerenciar políticas de alerta no Monitor.
Verificar o status da integração com o ServiceNow
Você pode visualizar o status da integração com o serviço ITSM Adapter na página Monitor > Integrações e Exportações de Dados. Esta página exibe:
-
O status atual da integração:
-
Começar: Indica que a integração do ITSM Adapter não foi configurada. Selecione esta opção para iniciar o processo de configuração inicial.
-
Gerenciar: Indica que a integração do ITSM Adapter está ativa e operacional. Selecione esta opção para visualizar ou modificar suas configurações de integração com o ServiceNow.
-
-
A URL da instância do ServiceNow associada (visível apenas quando uma instância do ServiceNow foi configurada no ITSM Adapter).
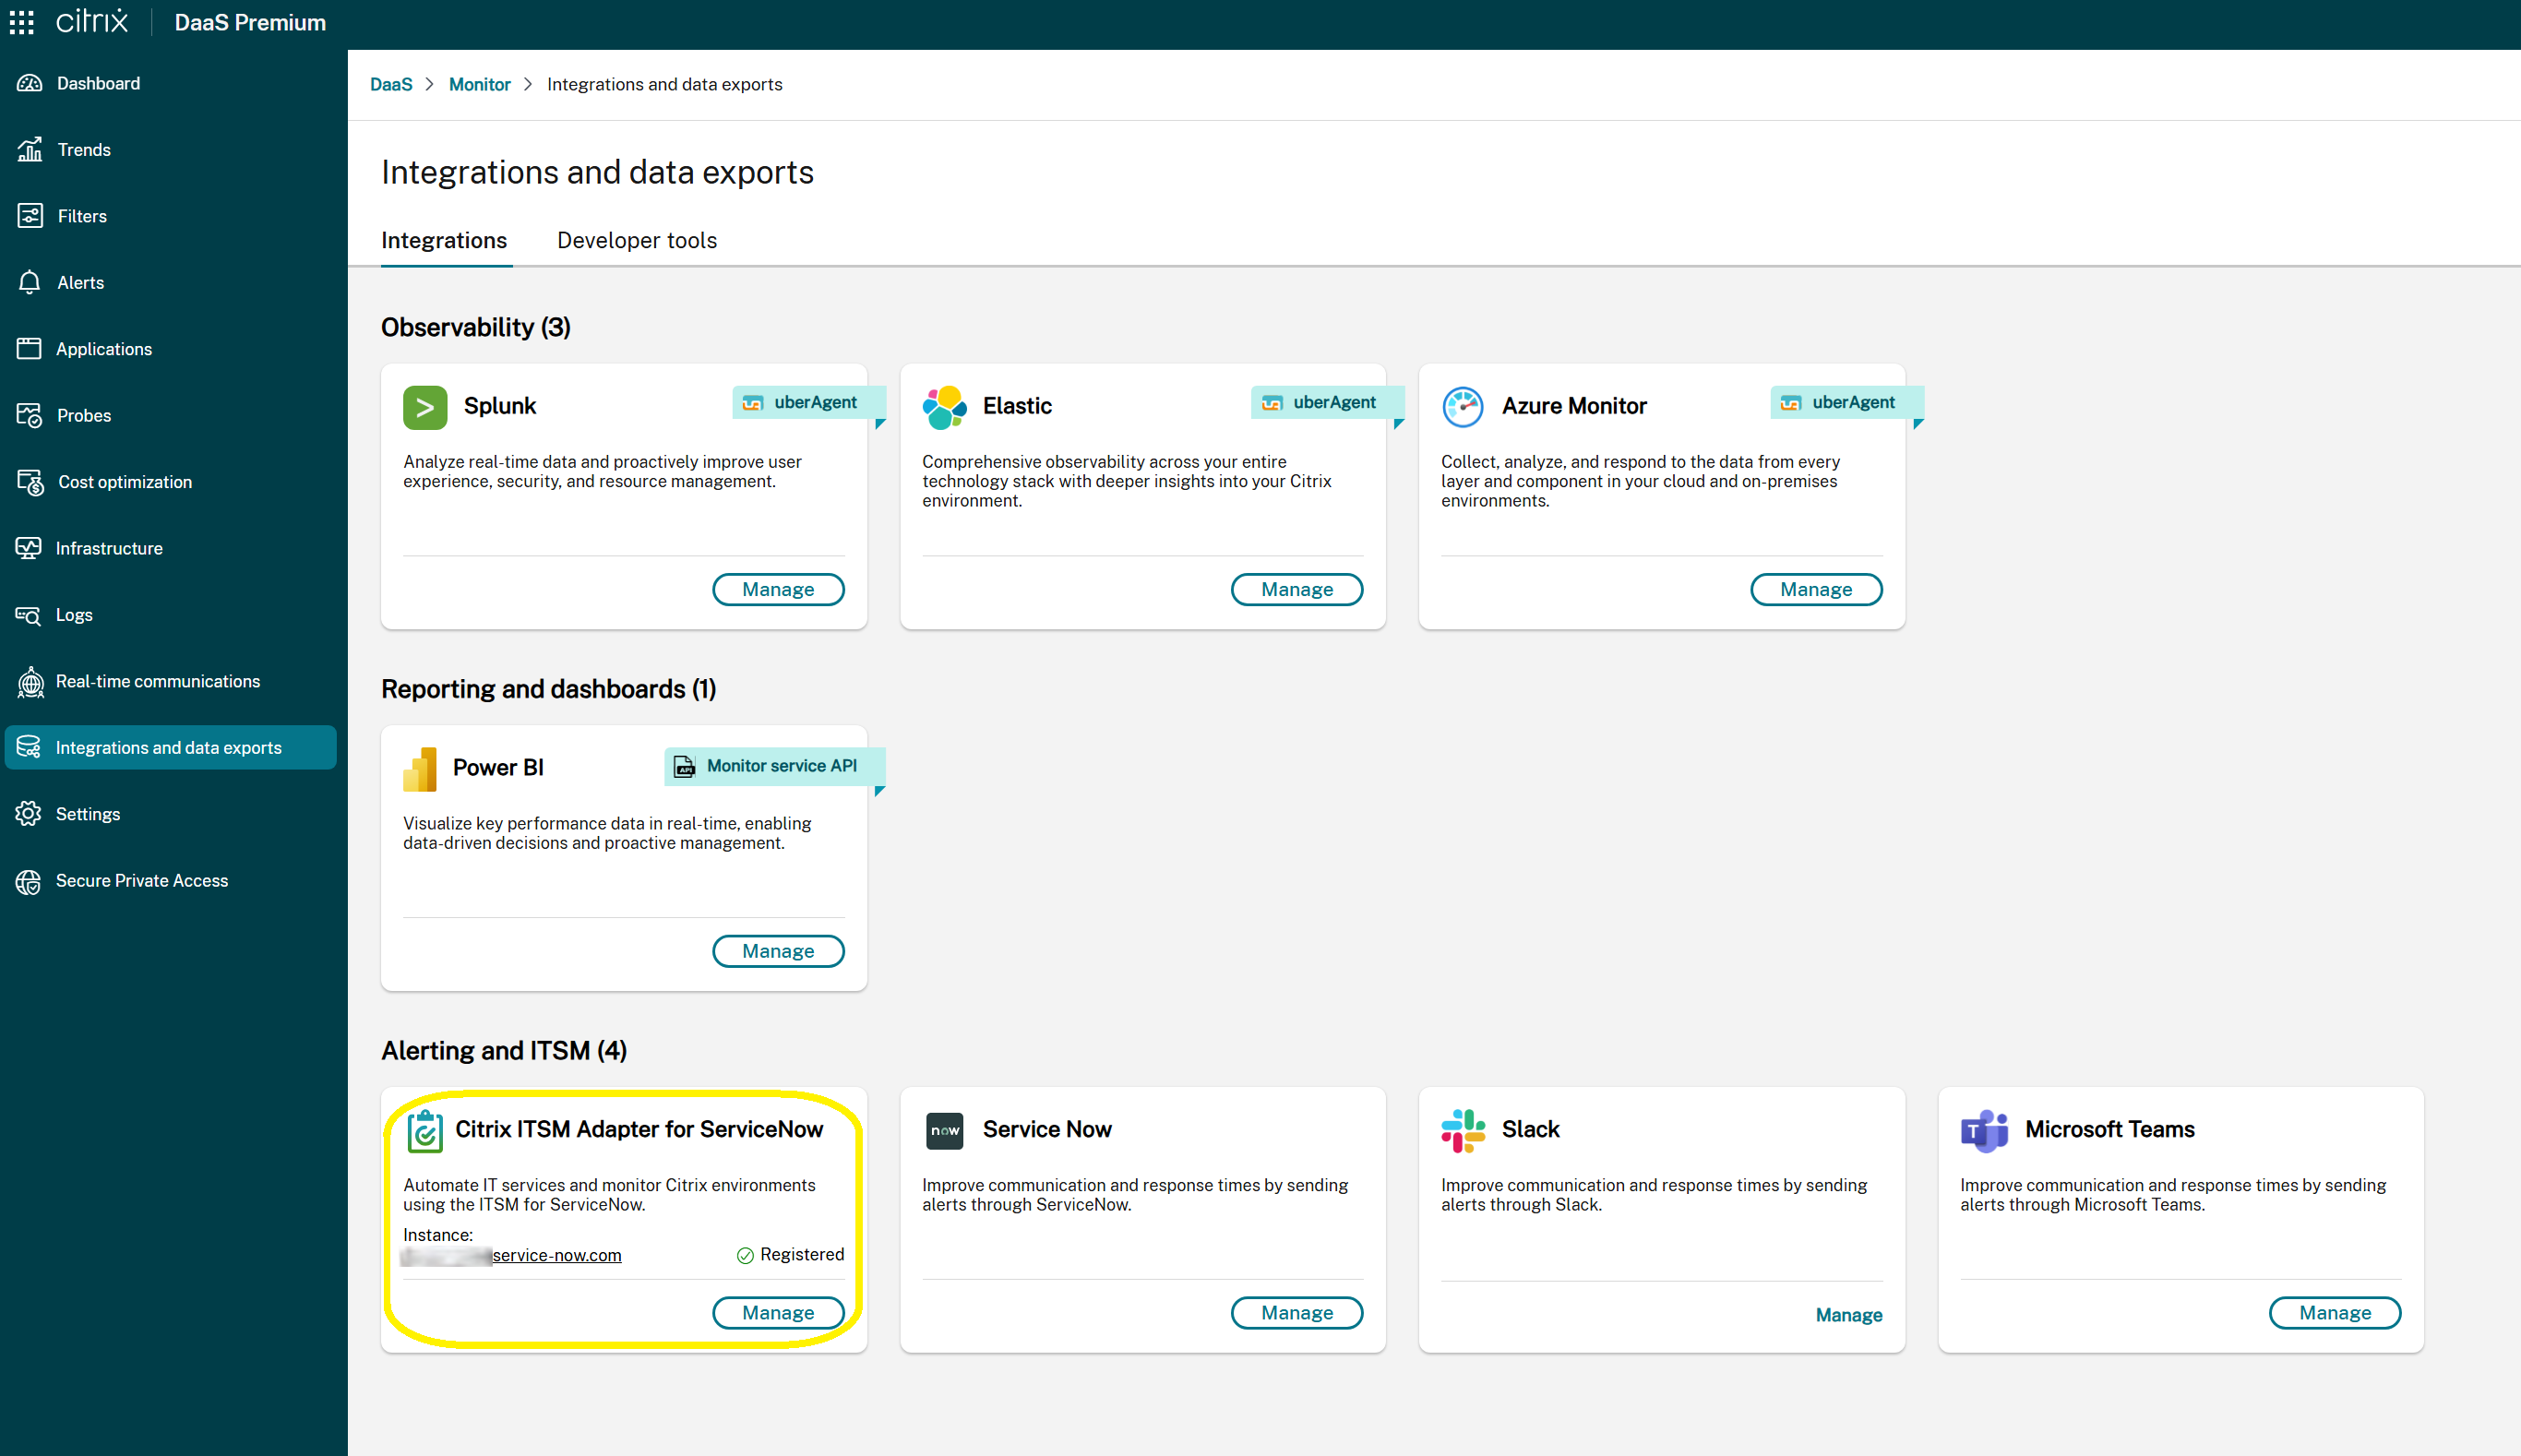
Configurar uma política de alerta com notificações do ServiceNow
Para configurar uma política de alerta para enviar notificações ao ServiceNow:
-
Vá para Alertas > Política de Alertas do Citrix e selecione a categoria da política (por exemplo, Política de SO Multissessão).
-
Clique em Criar para criar uma nova política ou selecione uma política existente e clique em Editar.
-
Configure as condições da política conforme necessário.
-
Na seção Preferências de notificação, procure a opção Integração do ServiceNow:
-
Se o Adaptador ITSM estiver disponível:
-
Marque a caixa de seleção para habilitar as notificações de alerta via ServiceNow para esta política.
-
A URL da instância do ServiceNow associada é exibida para referência.
-
Se a política já tiver um webhook configurado, uma mensagem de aviso informará que a habilitação da integração do ServiceNow substitui a configuração de webhook existente.
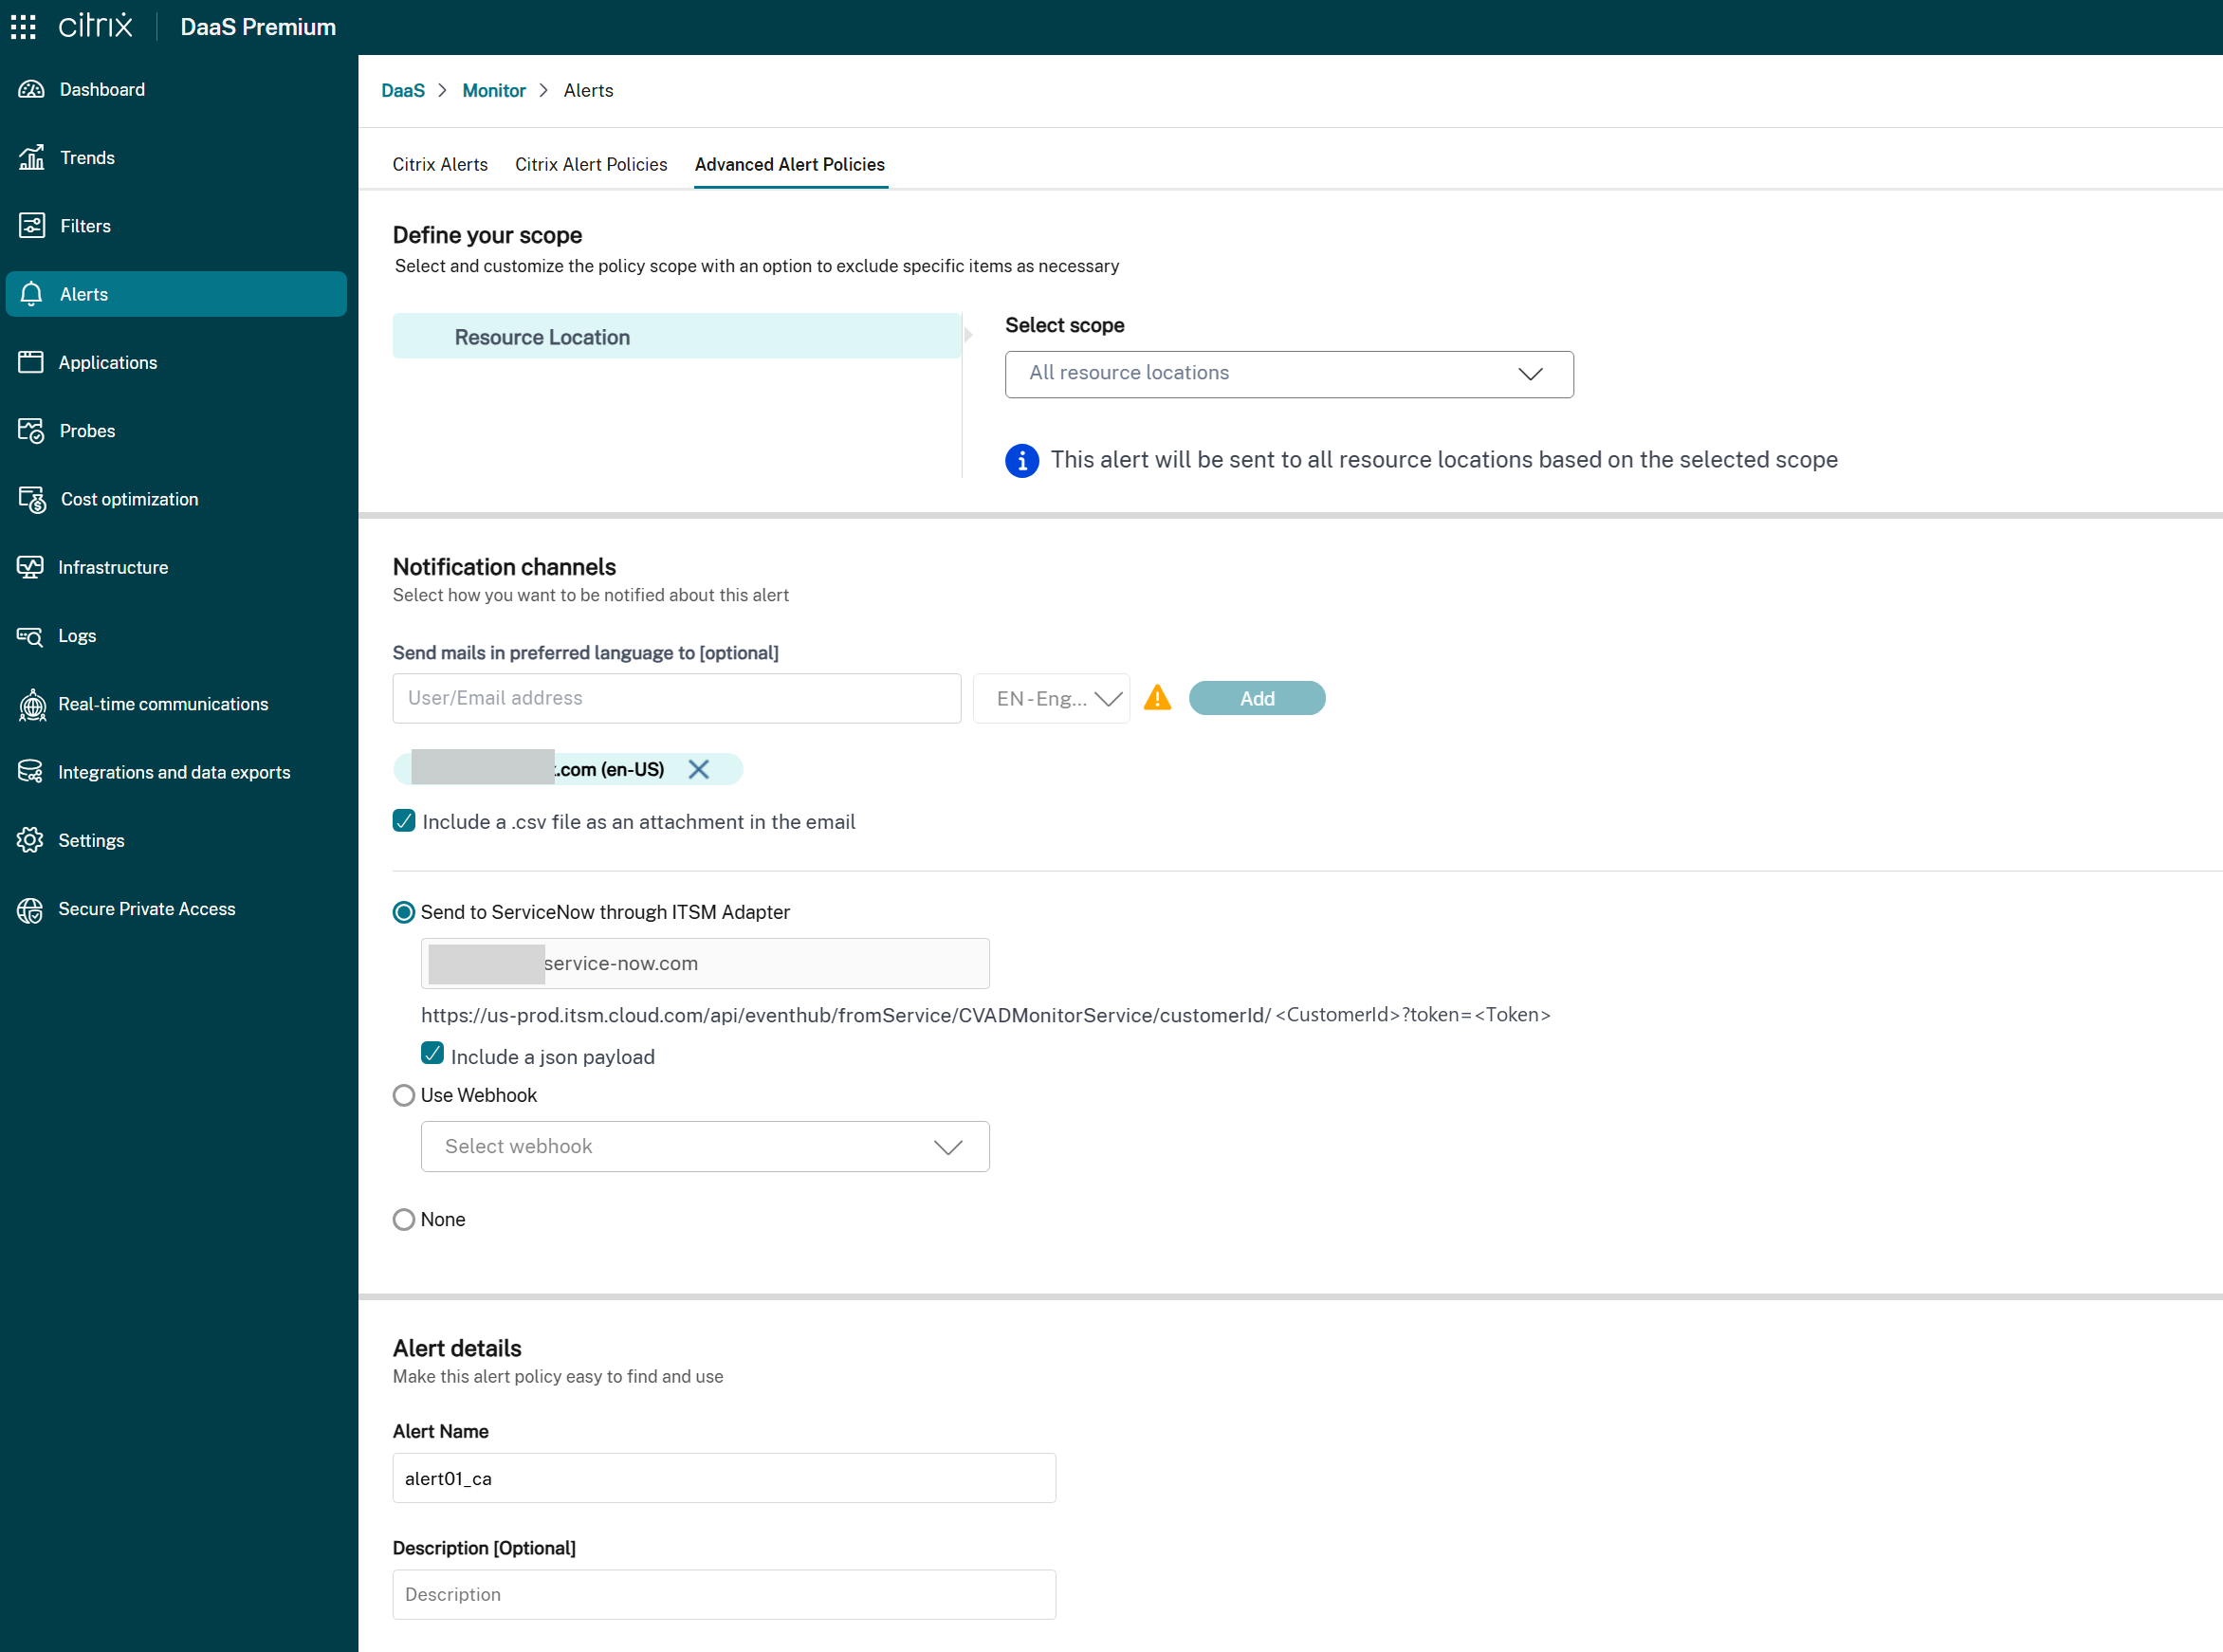
-
-
Se o Adaptador ITSM não estiver disponível:
-
Uma mensagem indica que a integração ITSM não está configurada no momento.
-
Clique em Começar para acessar a configuração da integração. Para obter detalhes, consulte a documentação.
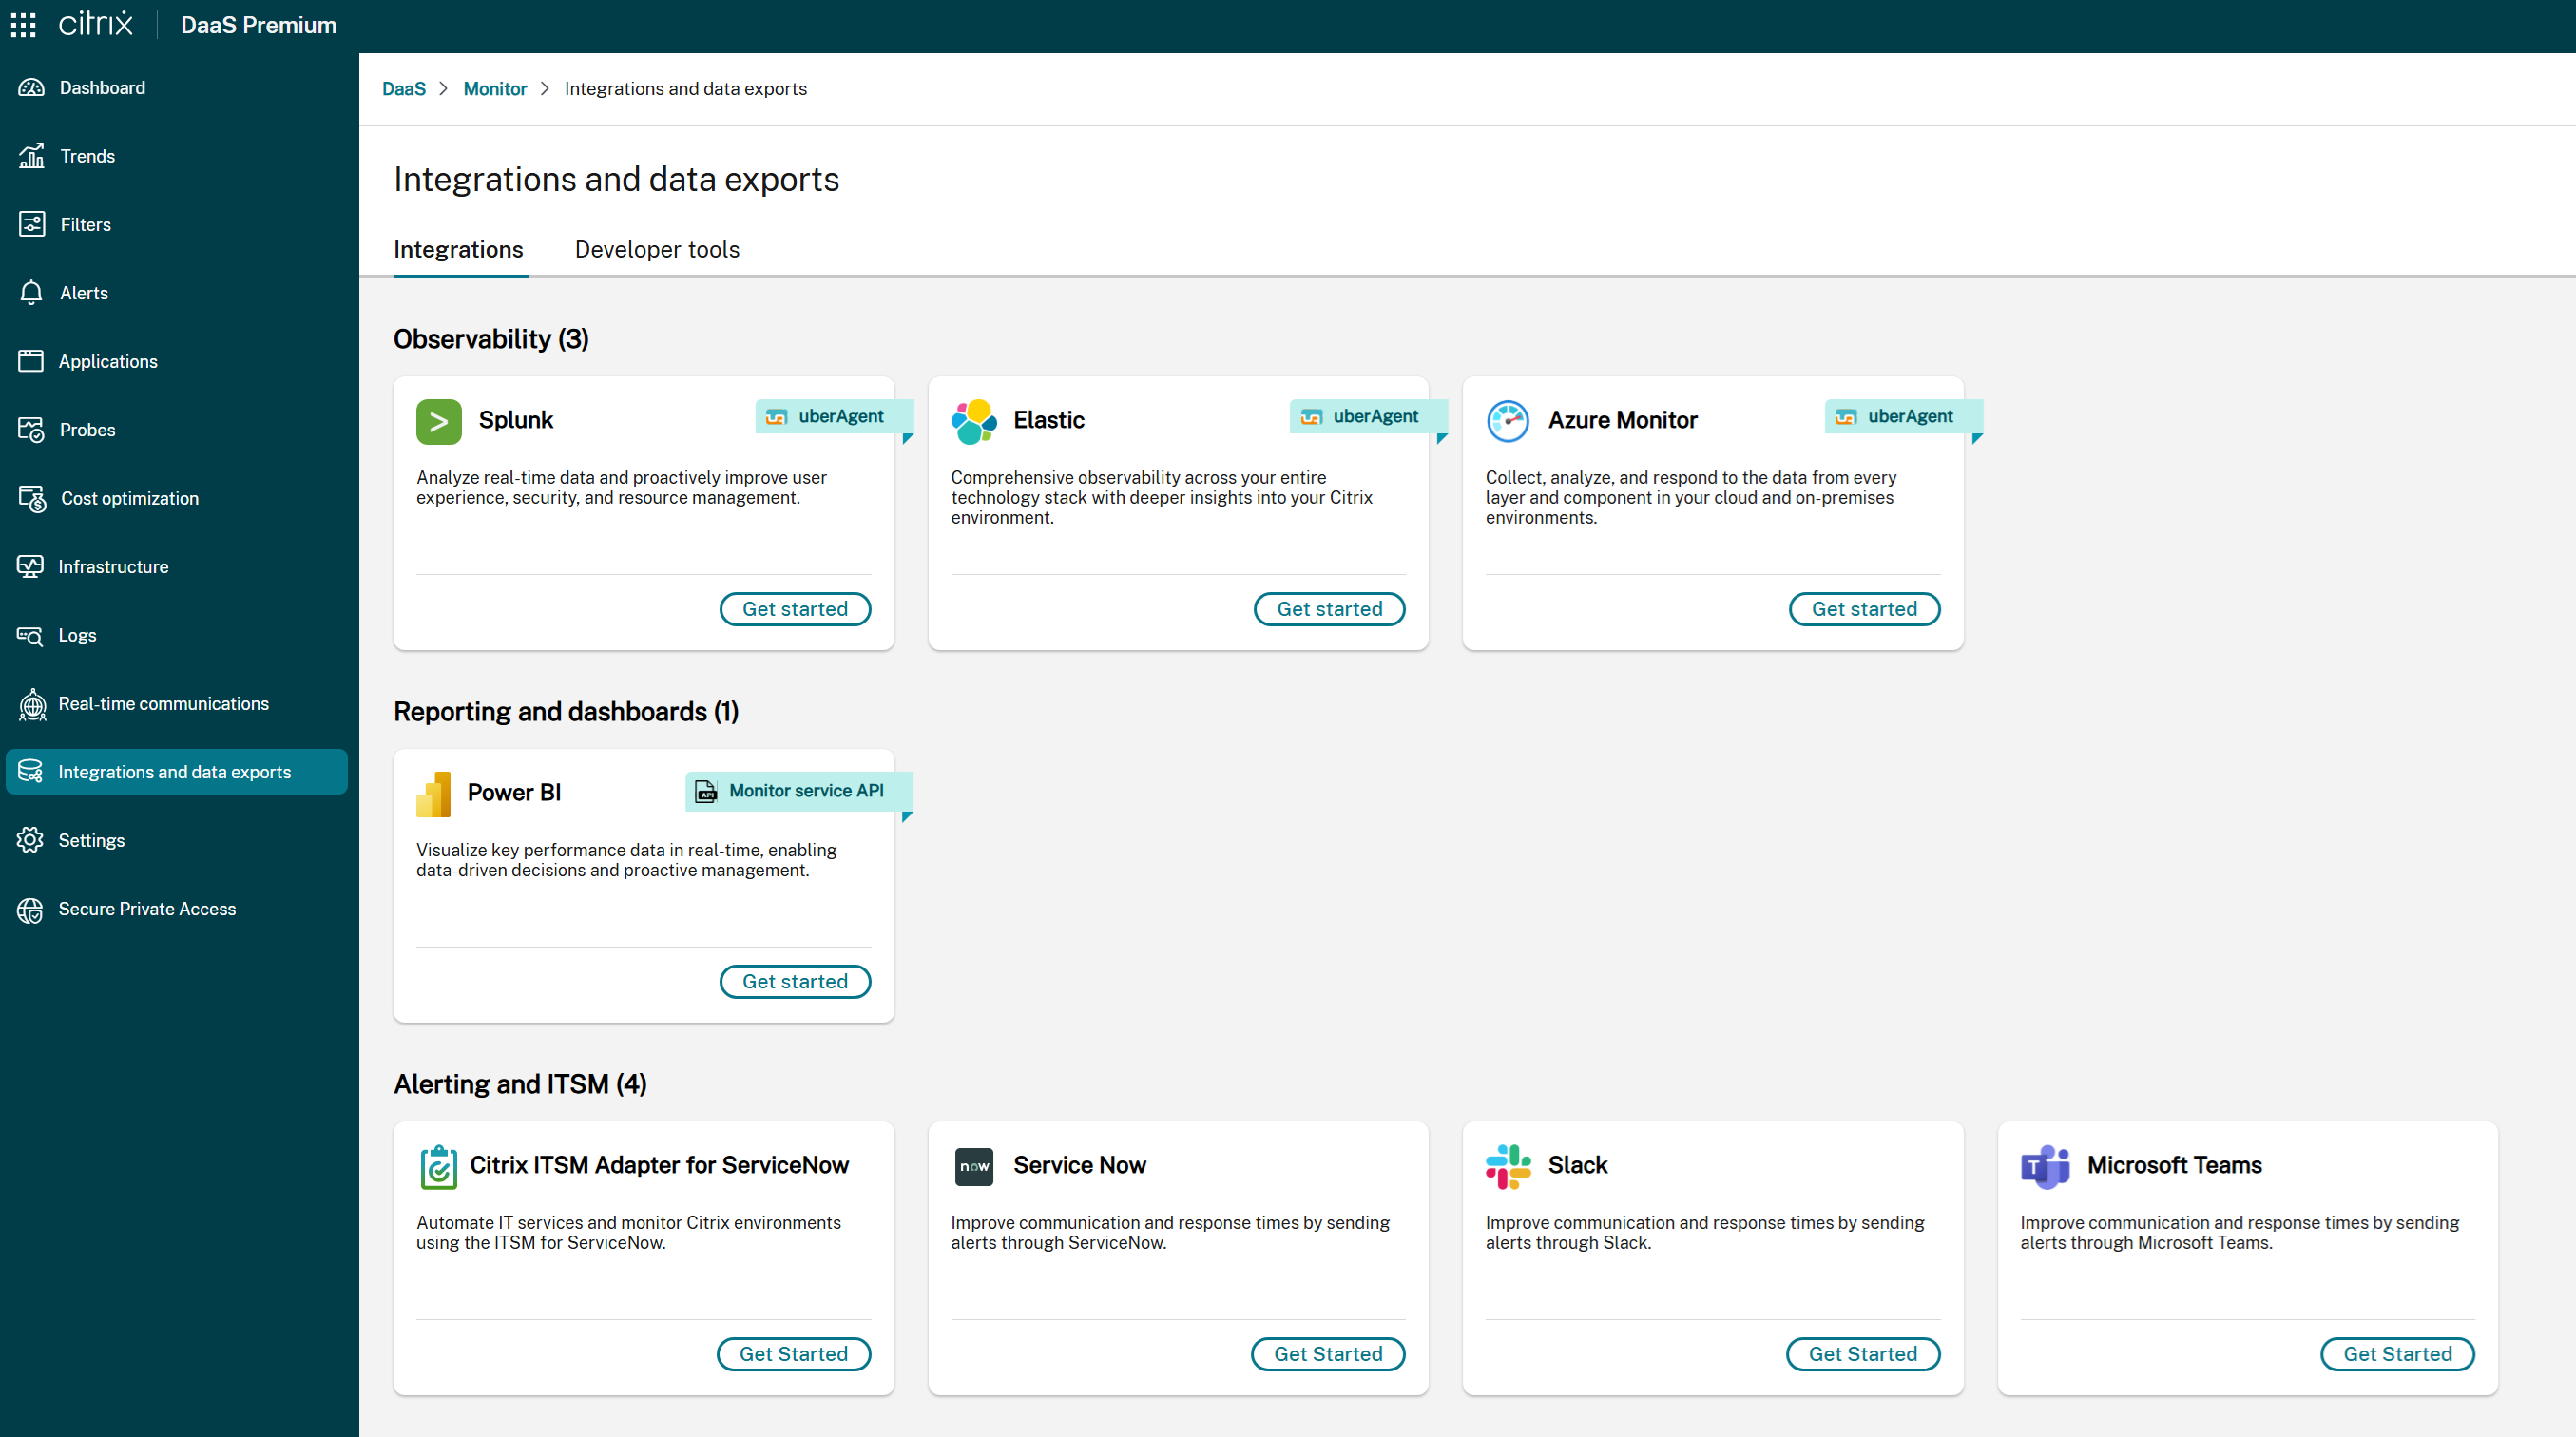
-
-
-
Clique em Salvar para salvar a política.
Uma vez configurados, os alertas que atendem às condições da política são automaticamente encaminhados para o ServiceNow, onde podem ser gerenciados como incidentes ou eventos com base na sua configuração ITSM.
Descarte em massa de alertas
Este recurso otimiza o processo de gerenciamento de alertas para administradores, proporcionando flexibilidade e reduzindo a fadiga de alertas. Os administradores podem descartar alertas em massa com base no tempo, tipo ou categoria, simplificando o gerenciamento de alertas durante a manutenção ou ao lidar com hipervisores e outros ambientes.
O descarte em massa de alertas ajuda os administradores a gerenciar sua carga de trabalho de forma eficiente e os impede de serem sobrecarregados por um alto volume de alertas.
Etapas para descartar alertas em massa
-
navegar para a guia Alertas > Alertas Citrix. Os alertas são exibidos.
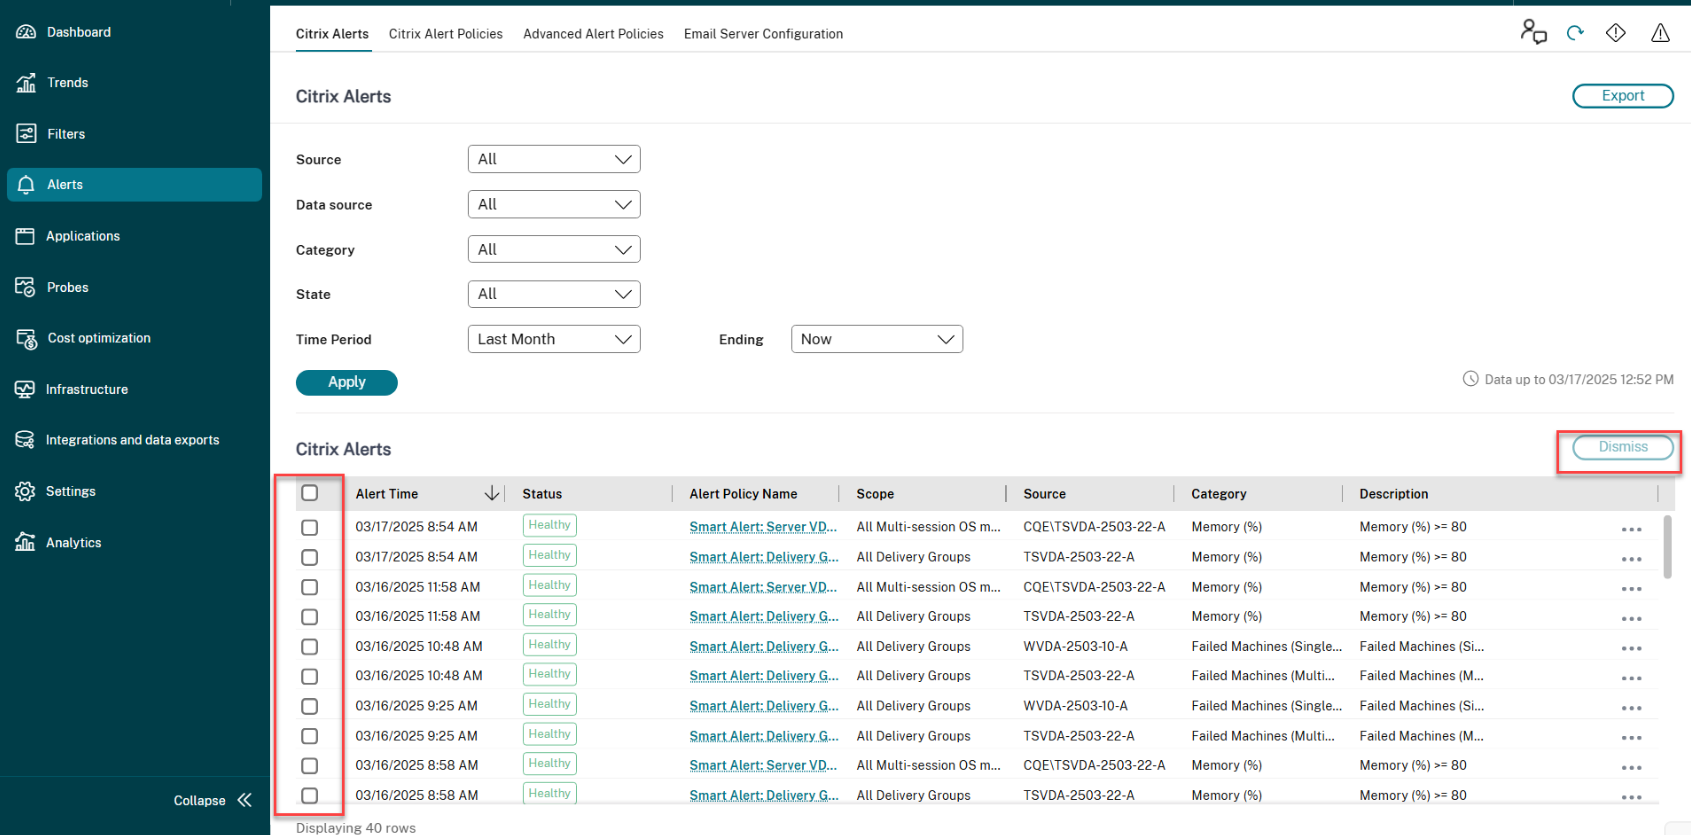
-
Selecione uma opção em Origem, Categoria, Estado ou Período de Tempo para filtrar os alertas que você deseja descartar. Os alertas específicos são exibidos.
-
Selecione a caixa de seleção ao lado de um alerta específico ou na parte superior para selecionar todos os alertas.
-
Clique em Descartar. Uma notificação aparece para confirmar o descarte dos alertas.
-
Clique em Sim. Os alertas selecionados são marcados como descartados, e o status do alerta é atualizado de acordo.
Configuração de webhook usando o SDK do PowerShell
O recurso de configuração de webhook usando o SDK do PowerShell permite que os administradores criem, modifiquem, excluam e listem perfis de webhook. Este recurso oferece flexibilidade na configuração de webhooks, permitindo a especificação de cabeçalhos, tipos de autenticação, tipos de conteúdo, payloads e URLs de webhook.
Nota:
O formato de payload suportado é texto e o usuário final deve habilitar o texto em seu webhook.
O formato de payload mais recente é:
{"text": "This is a message from a Webex incoming webhook."}
Criar um webhook
Você pode usar o seguinte comando PowerShell de exemplo para criar um perfil de webhook:
Criar um webhook sem cabeçalho de autorização:
$headers = [System.Collections.Generic.Dictionary[string,string]]::new()

 $headers.Add("Content-Type", "application/json")

 $payloads = '{ "text": "$PAYLOAD" }'

 $url = "<Fill this field with the required URL>"

 Add-MonitorWebhookProfile -Name "webhookprofile1" -Description "Description" -Url $url -Headers $headers -PayloadFormat $payloads -Platform Slack -Type Webhook -MethodType POST
Criar um webhook com cabeçalho de autorização:
$headers = [System.Collections.Generic.Dictionary[string,string]]::new()

 $headers.Add("Content-Type", "application/json")

 $headers.Add("Authorization", "Basic <Fill this field with the authorization token>")

 $payloads = '{ "text": "$PAYLOAD" }'

 $url = "<Fill this field with the required URL>"

 Add-MonitorWebhookProfile -Name "webhookprofile1" -Description "Description" -Url $url -Headers $headers -PayloadFormat $payloads -Platform Slack -Type Webhook -MethodType POST
Exemplo:
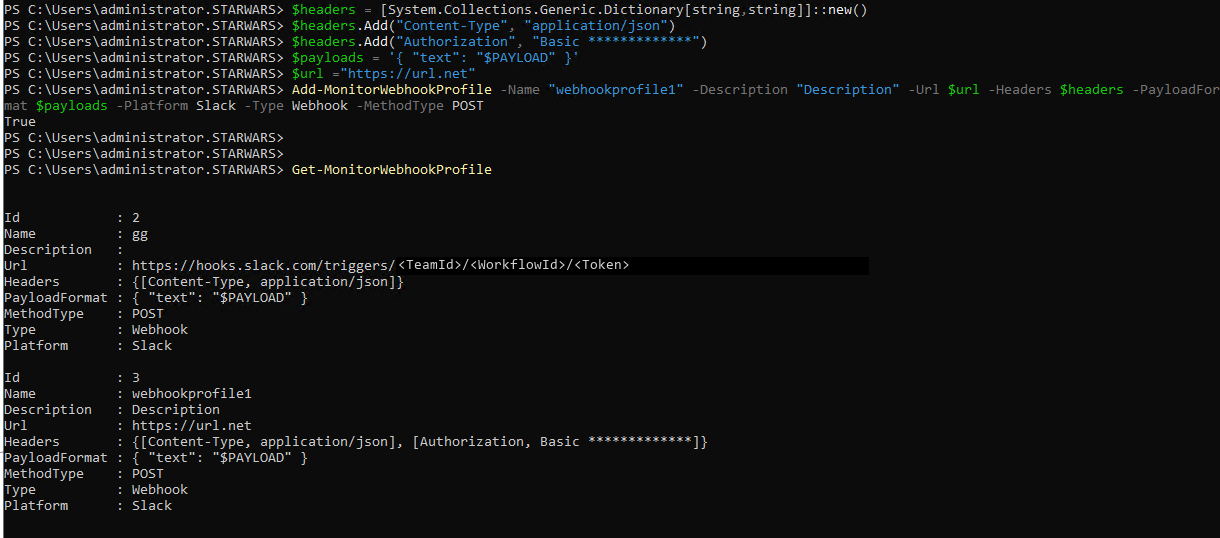
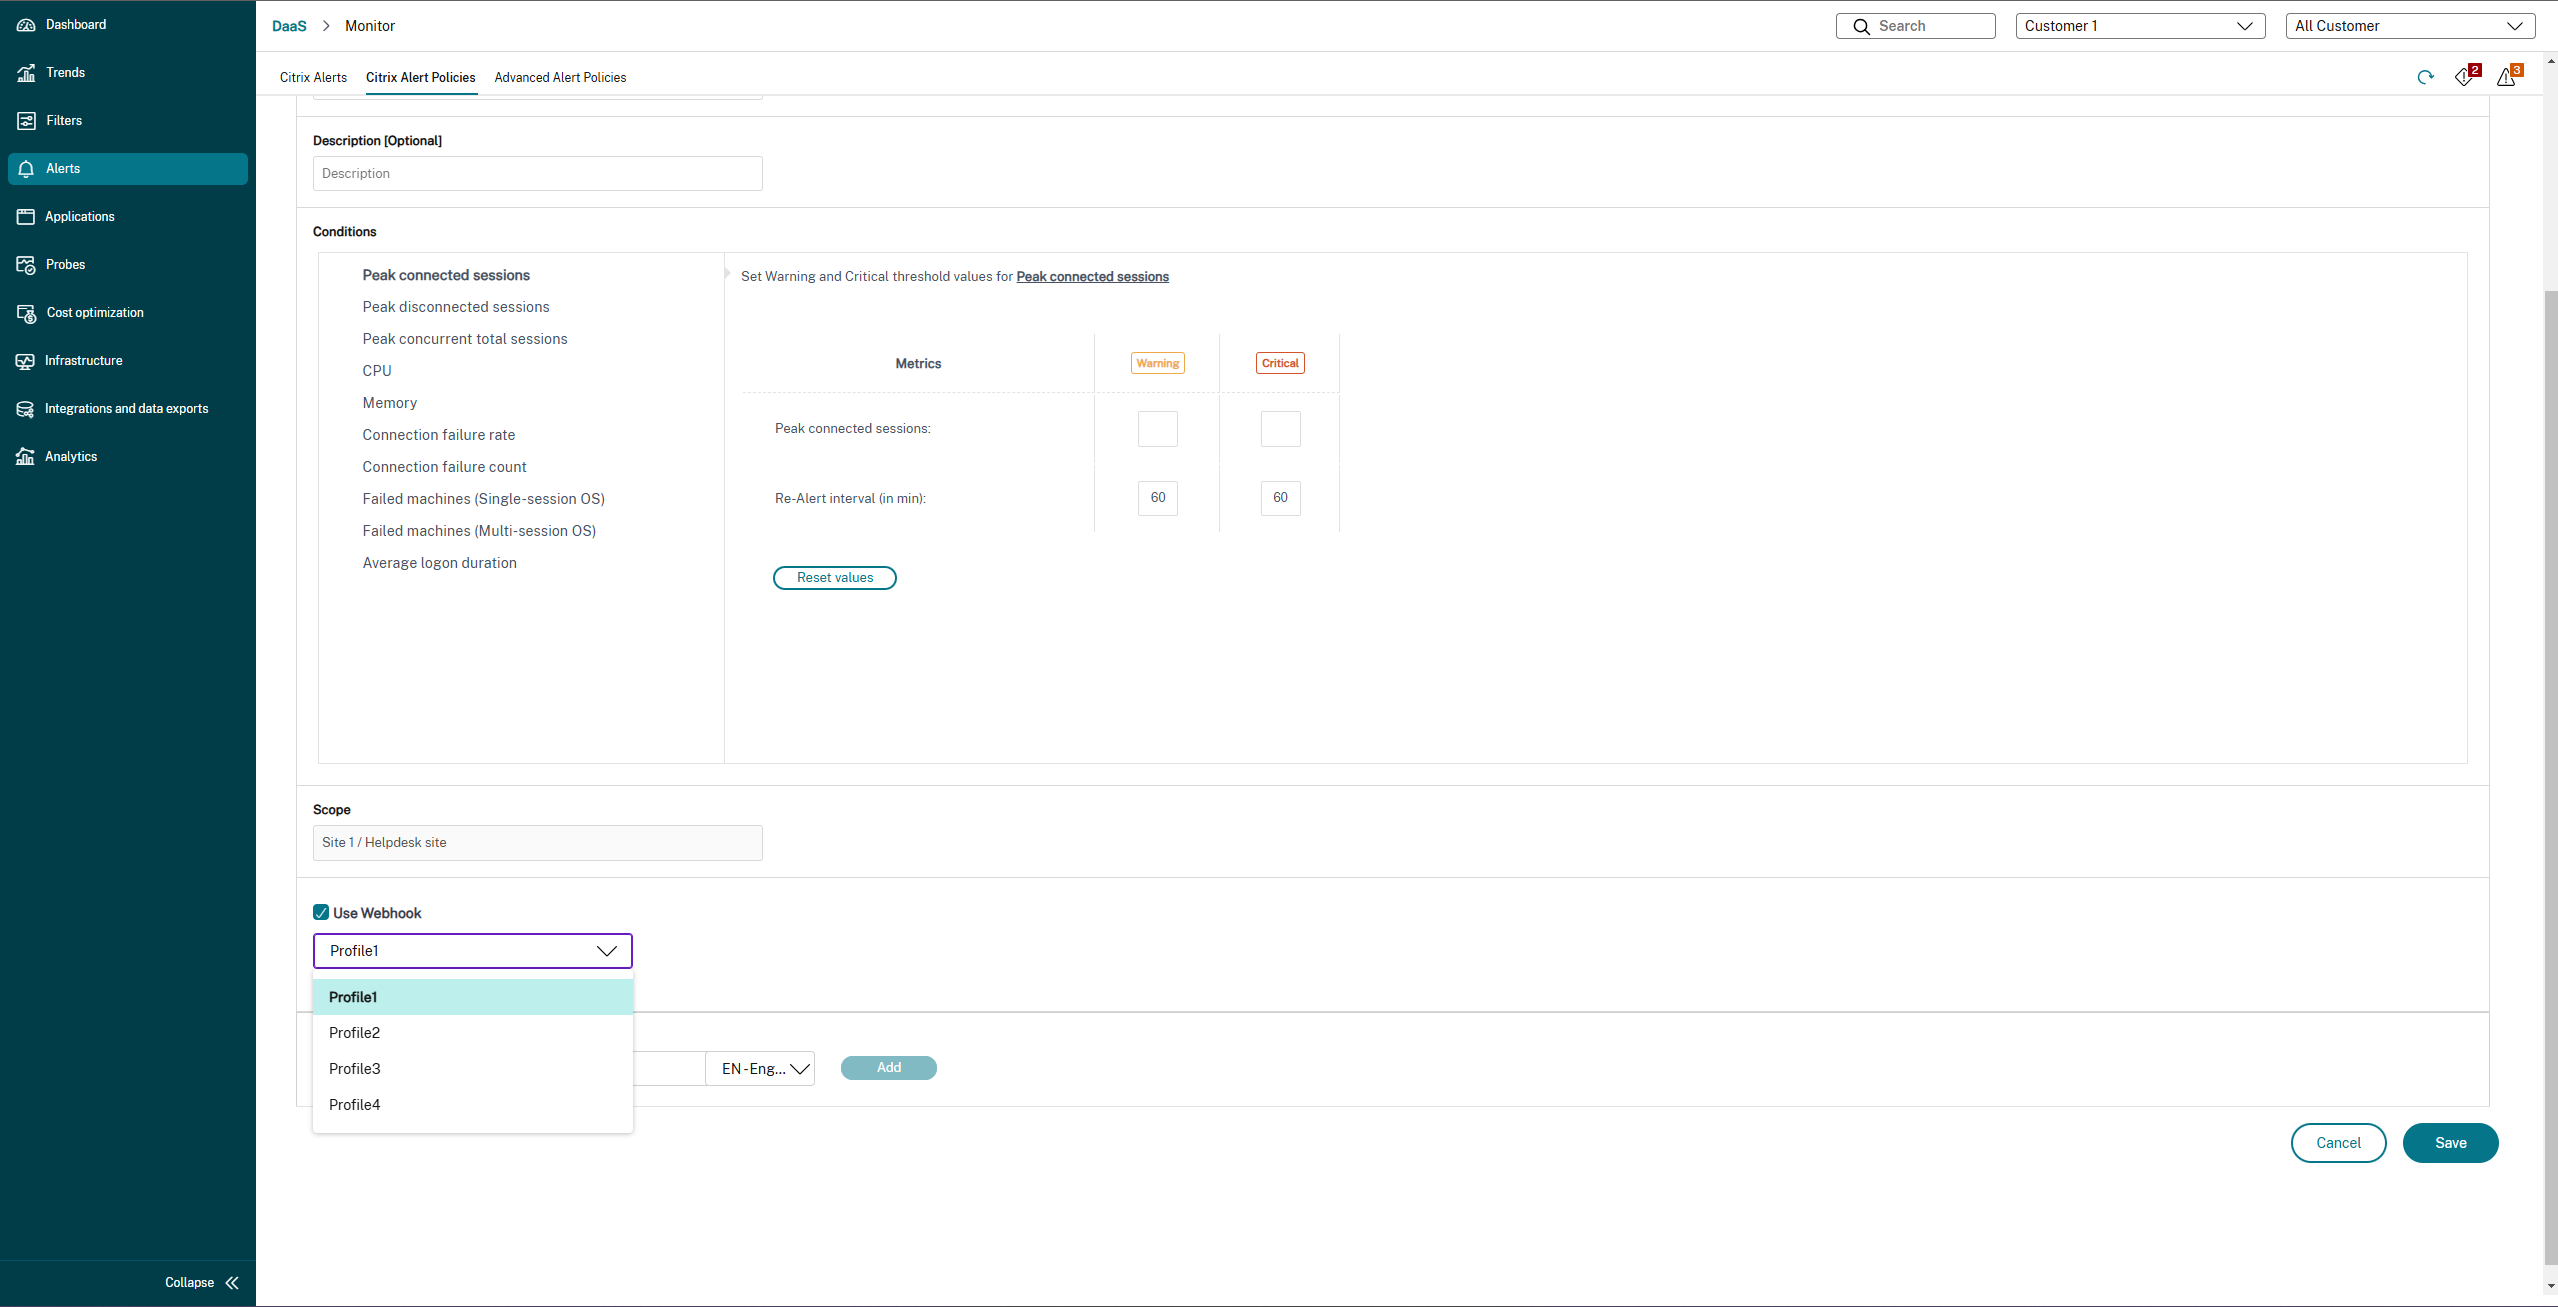
Depois que o perfil for criado, você poderá verificá-lo no banco de dados. Além disso, você pode encontrar o perfil de webhook recém-criado na página Alertas do Citrix.
Atualizar um perfil de webhook
Você pode usar o seguinte comando PowerShell de exemplo para atualizar um perfil de webhook:
$headers = [System.Collections.Generic.Dictionary[string,string]]::new()

 $headers.Add("Content-Type", "application/json")

 $payloads = '{ "text": "$PAYLOAD" }'

 $url =  "<Fill this field with the required URL>"

 Set-MonitorWebhookProfile -Uid 1  -Name "profile_slack_citrix" -Description "webhook profile for citrix slack" -Url $url -Headers $headers -PayloadFormat $payloads -Platform Slack -Type Webhook -MethodType POST
Exemplo:
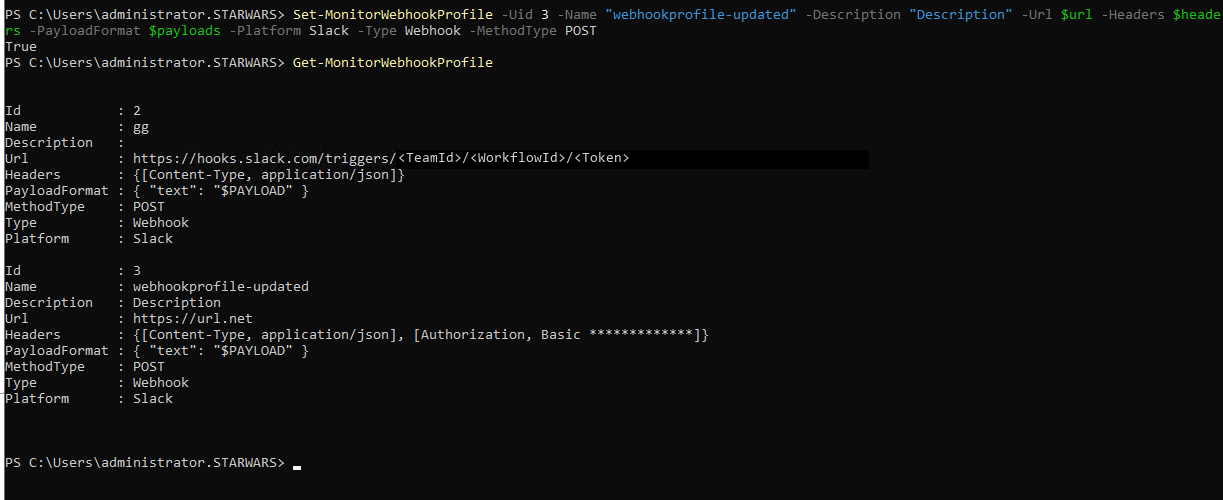
Obter uma lista de todos os perfis de webhook
Você pode usar o seguinte comando de exemplo do PowerShell para obter uma lista de todos os perfis de webhook disponíveis:
Get-MonitorWebhookProfile

 Get-MonitorWebhookProfile -Name 'profile_msteams'

 Get-MonitorWebhookProfile -Uid 1
Remover um perfil de webhook
Você pode usar o seguinte comando de exemplo do PowerShell para remover um perfil de webhook:
Remove-MonitorWebhookProfile -Uid 1
Nota:
Se um perfil de webhook estiver mapeado para alguma política, ele não poderá ser removido. Como solução alternativa, você deve primeiro remover o mapeamento do webhook da política.
Criar uma política com perfil de webhook
Você pode usar o seguinte comando de exemplo do PowerShell para criar uma política com perfil de webhook:
New-MonitorNotificationPolicy -Name "Policy1" -Description "Policy Description" -Enabled $true -WebhookProfileId 1
Atualizar uma política com perfil de webhook
Você pode usar o seguinte comando de exemplo do PowerShell para atualizar uma política com perfil de webhook:
$Policy = Set-MonitorNotificationPolicy -Uid 1 -WebhookProfileId 1
Remover mapeamento de webhook de uma política
Você pode usar o seguinte comando de exemplo do PowerShell para remover o perfil de webhook de uma política:
$Policy = Set-MonitorNotificationPolicy -Uid 1 -WebhookProfileId 0
Testar perfil de webhook
Você pode usar o seguinte comando de exemplo do PowerShell para testar o perfil de webhook:
$headers = [System.Collections.Generic.Dictionary[string,string]]::new()

 $headers.Add("Content-Type", "application/json")

 $headers.Add("Authorization", "Basic <Fill this with authorization token>")

 $payloads = '{ "text": "$PAYLOAD" }'

 $url ="<Fill this field with the required URL>"

 Test-MonitorWebhookProfile -Url $url -Headers $headers -PayloadFormat $payloads
Monitoramento de alerta de falha de sincronização de configuração do Local Host Cache
O Cache de Host Local permite que as sessões de usuário continuem mesmo que os Cloud Connectors percam a conectividade com o Citrix Cloud. O cache usado pelo Cache de Host Local é sincronizado regularmente com o banco de dados primário para garantir configurações atualizadas quando o modo de Cache de Host Local é ativado. Você pode obter mais informações sobre o Cache de Host Local e o processo de sincronização de configuração em Cache de Host Local. Se a sincronização de configuração falhar mais de três vezes consecutivas, o Citrix Monitor envia um alerta de aviso ao administrador.
Uma política de alerta predefinida chamada Cache de Host Local - Falha na Sincronização de Configuração foi introduzida no Citrix Monitor para notificar os administradores sobre falhas na sincronização de configuração. Você pode encontrar a política recém-introduzida em Monitor > Alertas do Citrix. Você pode modificar a política predefinida para adicionar ou editar destinatários de e-mail ou webhooks para receber notificações proativas em suas ferramentas de gerenciamento de alertas ou ITSM.
O escopo da política de alerta Cache de Host Local - Falha na Sincronização de Configuração é limitado apenas ao Site.
Monitoramento de Alertas de Hypervisor
O Monitor exibe alertas para monitorar a integridade do hypervisor. Alertas do Citrix Hypervisor™ e VMware vSphere ajudam a monitorar parâmetros e estados do hypervisor. O status da conexão com o hypervisor também é monitorado para fornecer um alerta se o cluster ou pool de hosts for reiniciado ou estiver indisponível.
Para receber alertas de hypervisor, certifique-se de que uma conexão de hospedagem seja criada na guia Gerenciar. Para obter mais informações, consulte Conexões e recursos. Somente essas conexões são monitoradas para alertas de hypervisor. A tabela a seguir descreve os vários parâmetros e estados dos alertas de Hypervisor.
| Alerta | Hypervisores Suportados | Acionado por | Condição | Configuração |
|---|---|---|---|---|
| Uso da CPU | Citrix Hypervisor, VMware vSphere | Hypervisor | O limite de alerta de uso da CPU é atingido ou excedido | Os limites de alerta devem ser configurados no Hypervisor. |
| Uso de memória | Citrix Hypervisor, VMware vSphere | Hypervisor | O limite de alerta de uso de memória é atingido ou excedido | Os limites de alerta devem ser configurados no Hypervisor. |
| Uso de rede | Citrix Hypervisor, VMware vSphere | Hypervisor | O limite de alerta de uso de rede é atingido ou excedido | Os limites de alerta devem ser configurados no Hypervisor. |
| Uso de disco | VMware vSphere | Hypervisor | O limite de alerta de uso de disco é atingido ou excedido | Os limites de alerta devem ser configurados no Hypervisor. |
| Conexão do host ou estado de energia | VMware vSphere | Hypervisor | O Host do Hypervisor foi reiniciado ou está indisponível | Os alertas são pré-construídos no VMware vSphere. Nenhuma configuração adicional é necessária. |
| Conexão do Hypervisor indisponível | Citrix Hypervisor, VMware vSphere | Delivery Controller | A conexão com o hypervisor (pool ou cluster) foi perdida, desligada ou reiniciada. Este alerta é gerado a cada hora enquanto a conexão estiver indisponível. | Os alertas são pré-construídos com o Delivery Controller. Nenhuma configuração adicional é necessária. |
Nota:
Para obter mais informações sobre a configuração de alertas, consulte Alertas do Citrix XenCenter ou verifique a documentação de Alertas do VMware vCenter.
A preferência de notificação por e-mail pode ser configurada em Citrix Alerts Policy > Site Policy > Hypervisor Health. As condições de limite para as políticas de alerta do Hypervisor podem ser configuradas, editadas, desabilitadas ou excluídas apenas no hypervisor e não no Monitor. No entanto, a modificação das preferências de e-mail e o descarte de um alerta podem ser feitos no Monitor.
Importante:
-
Todos os alertas de hipervisor com mais de um dia são automaticamente ignorados.
-
Os alertas acionados pelo Hipervisor são buscados e exibidos no Monitor. No entanto, as alterações no ciclo de vida/estado dos alertas do Hipervisor não são refletidas no Monitor.
-
Alertas que estão saudáveis, ignorados ou desabilitados no console do Hipervisor continuarão a aparecer no Monitor e devem ser ignorados explicitamente.
-
Alertas que são ignorados no Monitor não são ignorados automaticamente no console do Hipervisor.
Filtro de Alertas do Hipervisor(/en-us/citrix-daas/media/hypervisor_alerts_filter.png)
Uma nova categoria de Alerta chamada Integridade do Hipervisor foi adicionada para permitir a filtragem apenas dos alertas do hipervisor. Esses alertas são exibidos assim que os limites são atingidos ou excedidos. Os alertas do hipervisor podem ser:
-
Crítico — limite crítico da política de alarme do hipervisor atingido ou excedido
-
Aviso — limite de aviso da política de alarme do hipervisor atingido ou excedido
-
Ignorado — alerta não mais exibido como um alerta ativo
Exibição de Alertas do Hipervisor(/en-us/citrix-daas/media/hypervisor_alerts_display.png)